Türkçe Karakterler Neden Bozulur? UTF-8, Windows-1254 ve Latin1 Karışıklığı
 Mustafa Kürşad BAŞER
Bozuk harf, yanlış tabloyla okunmuş bayttır
Özet (TL;DR)
- Ekranda "ç" ya da "ÅŸ" görmek, UTF-8 baytlarının tek baytlık bir kod sayfasıyla okunduğunu gösterir. Baytlar yerinde durduğu için bu bozulma geri çevrilir.
- "?" ile "�" aynı şey değildir. Soru işareti, harfin hedef karakter setinde bulunmadığı için dönüştürmede silindiğini söyler ve o bilgi geri gelmez. "�" (U+FFFD) ise geçersiz bir UTF-8 dizisinin işaretidir.
- MySQL'de bozulmanın en sık kaynağı tablo değil bağlantıdır. Uygulama UTF-8 bayt gönderip bağlantıyı latin1 ilan ederse sunucu her baytı ayrı bir harf sayar ve metni ikinci kez kodlar.
- MySQL'in
utf8karakter seti en fazla üç baytlık karakter saklar. Emoji gibi dört baytlık karakterler içinutf8mb4gerekir ve MySQL 8.0 varsayılan olarak bunu kullanır. - Bozuk veriyi yerinde onarmayın. Düzeltilmiş değeri yeni bir kolona yazın, tekrar bozup eskisiyle karşılaştırın ve yalnızca tutan satırları taşıyın.
Veritabanından gelen müşteri adı ekranda "ÇAÄžLAR" görünüyor. Aynı kayıt eski PHP panelinde düzgün, yeni yazdığınız serviste bozuk, phpMyAdmin'de de bozuk. Hangisi doğru söylüyor?
Üçü de aynı baytları okuyor. Fark, o baytları hangi tabloyla harfe çevirdiklerinde. İngilizce kaynaklar bu bozulmaya Japoncadan aldıkları bir adla mojibake diyor, kabaca "harf başkalaşması". Önce baytlara ne olduğuna, sonra belirtiden kaynağa nasıl gidileceğine ve bozuk veriyi geri çevirmeye bakalım.
ş harfi nasıl "ÅŸ" olur
UTF-8, Unicode kod noktalarını bir ile dört bayt arasında değişen dizilere çevirir. Kurallar RFC 3629'da tanımlı ve Türkçe harflerin hepsi iki baytlık biçime düşer. İlk bayt 110 bitleriyle, ikincisi 10 ile başlar. Kod noktasının 11 biti bu iki baytın boşluklarına dağıtılır. ş harfinin kod noktası U+015F, bitleri 00101 ve 011111 diye bölününce önlerine işaret bitleri eklenir ve C5 9F baytları çıkar.
Sorun, bu iki baytı okuyan program UTF-8 beklemediğinde başlıyor. Windows-1254 ya da latin1 gibi tek baytlık kod sayfalarında her bayt kendi başına bir harftir. Microsoft'un 1254 tablosunda C5 Å'ya, 9F Ÿ'ye karşılık gelir. Ekranda bir harf yerine iki harf görmenizin sebebi bu kadar basit.
harf = "ş"bayt = harf.encode("utf-8")print(f"U+{ord(harf):04X} -> {bayt.hex(' ').upper()}")print("cp1254 :", bayt.decode("cp1254"))print("cp1252 :", bayt.decode("cp1252"))print("8859-9 :", repr(bayt.decode("iso-8859-9"))) # Çıktı:# U+015F -> C5 9F# cp1254 : ÅŸ# cp1252 : ÅŸ# 8859-9 : 'Å\x9f'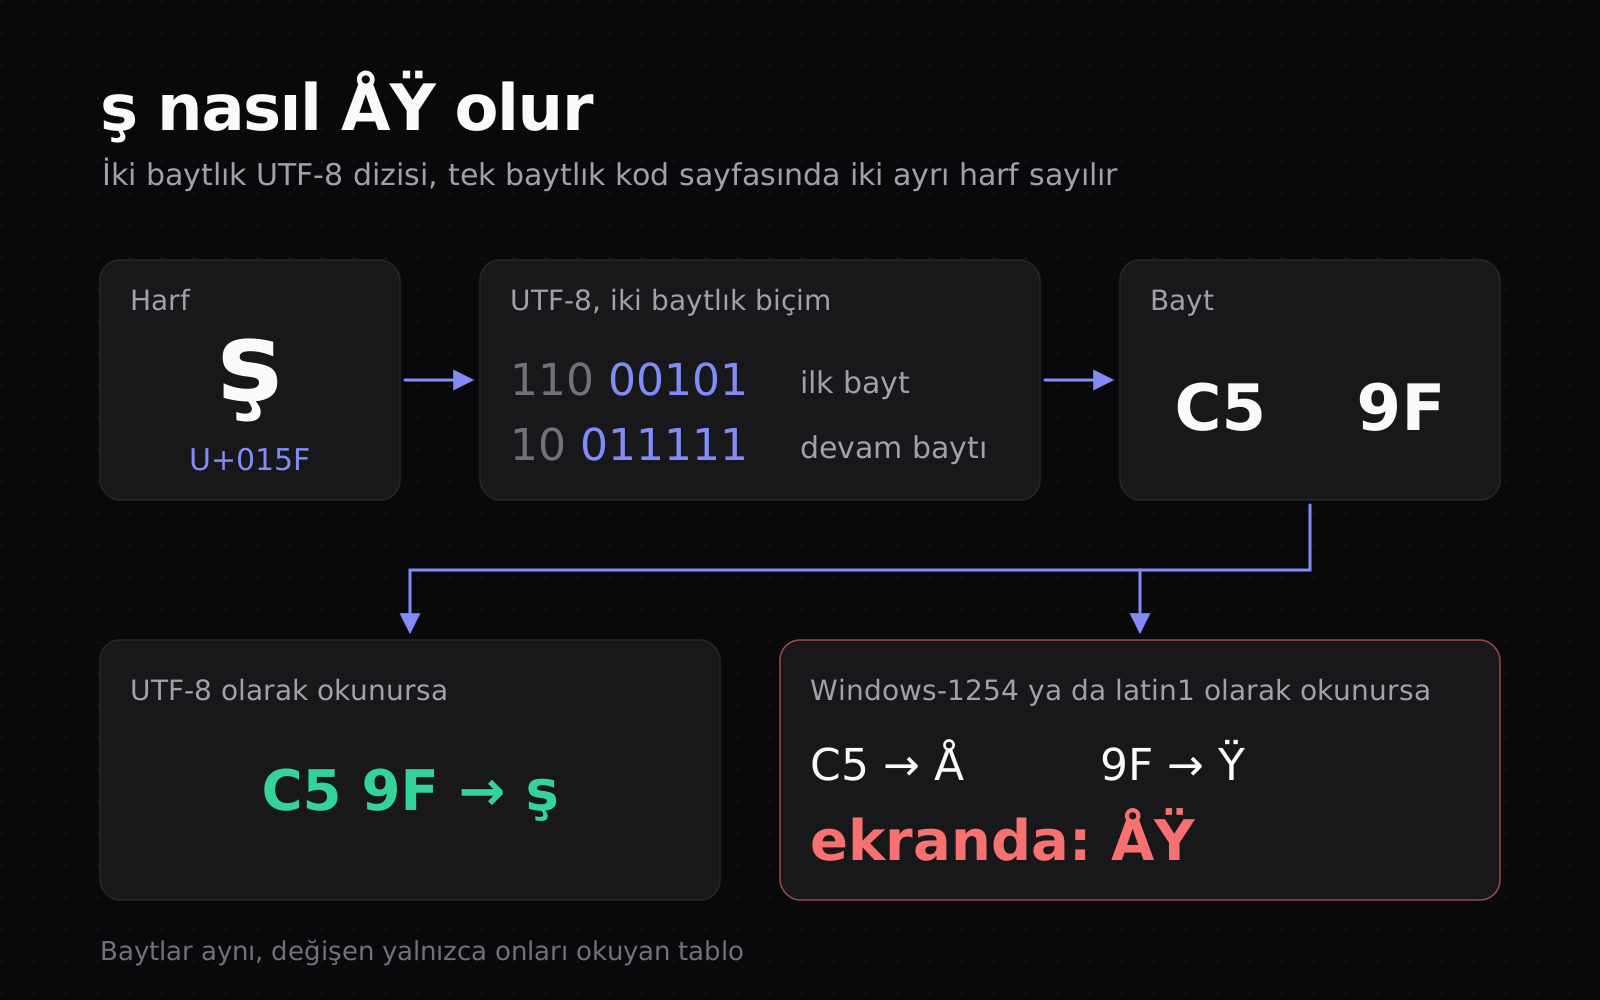
Aynı hesabı bütün Türkçe harfler için yapınca bozulmanın bir imzası olduğu ortaya çıkıyor. ç, ö ve ü (büyükleriyle birlikte) hep à ile başlıyor, çünkü ilk baytları C3. ğ, ı ve İ C4 yüzünden Ä ile, ş ve Ş da C5 yüzünden Å ile başlıyor. Bir metinde bu üç harften biri sık sık beliriyor ve arkasından bir sembol geliyorsa teşhis aşağı yukarı konmuş demektir.
| Harf | UTF-8 baytları | Windows-1254 ile okunursa | Windows-1252 (latin1) ile okunursa |
|---|---|---|---|
| ç | C3 A7 | ç | ç |
| Ç | C3 87 | Ç | Ç |
| ğ | C4 9F | ÄŸ | ÄŸ |
| Ğ | C4 9E | Ä + tanımsız bayt | Äž |
| ı | C4 B1 | ı | ı |
| İ | C4 B0 | Ä° | Ä° |
| ö | C3 B6 | ö | ö |
| Ö | C3 96 | Ö | Ö |
| ş | C5 9F | ÅŸ | ÅŸ |
| Ş | C5 9E | Å + tanımsız bayt | Åž |
| ü | C3 BC | ü | ü |
| Ü | C3 9C | Ãœ | Ãœ |
1254 mü okudu, 1252 mi?
Tablonun son iki sütunu neredeyse aynı. Windows-1254, Windows-1252'den yalnızca sekiz baytta ayrılır. Bunların altısı Türkçe harflerin konumu (D0, DD, DE, F0, FD, FE), kalan ikisi 8E ve 9E. UTF-8'in Türkçe harflerde kullandığı ilk baytlar iki tabloda da Ã, Ä ve Å olduğu için ayırt edici tek ipucu Ğ ile Ş'nin ikinci baytı olan 9E. Bu bayt Windows-1252'de ž, 1254'te tanımsız. Ekranda "Äž" ya da "Åž" görüyorsanız metni okuyan taraf latin1 kullanmış.
Burada "latin1" adı da yanıltıcı. Tarayıcılar WHATWG Encoding Standard'ı izler ve iso-8859-1 ya da latin1 etiketli bir sayfayı Windows-1252 ile, iso-8859-9 etiketli bir sayfayı Windows-1254 ile çözer. MySQL'in latin1 karakter seti de adına rağmen cp1252'dir. Yalnızca Python'un latin-1 codec'i gerçek ISO-8859-1'dir ve 80–9F aralığını kontrol karakteri sayar. Yukarıdaki çıktıdaki \x9f o yüzden görünmez bir karakter olarak kaldı ve aşağıdaki onarım kodunda cp1252 kullanmamın sebebi de bu.
Belirtiden teşhise
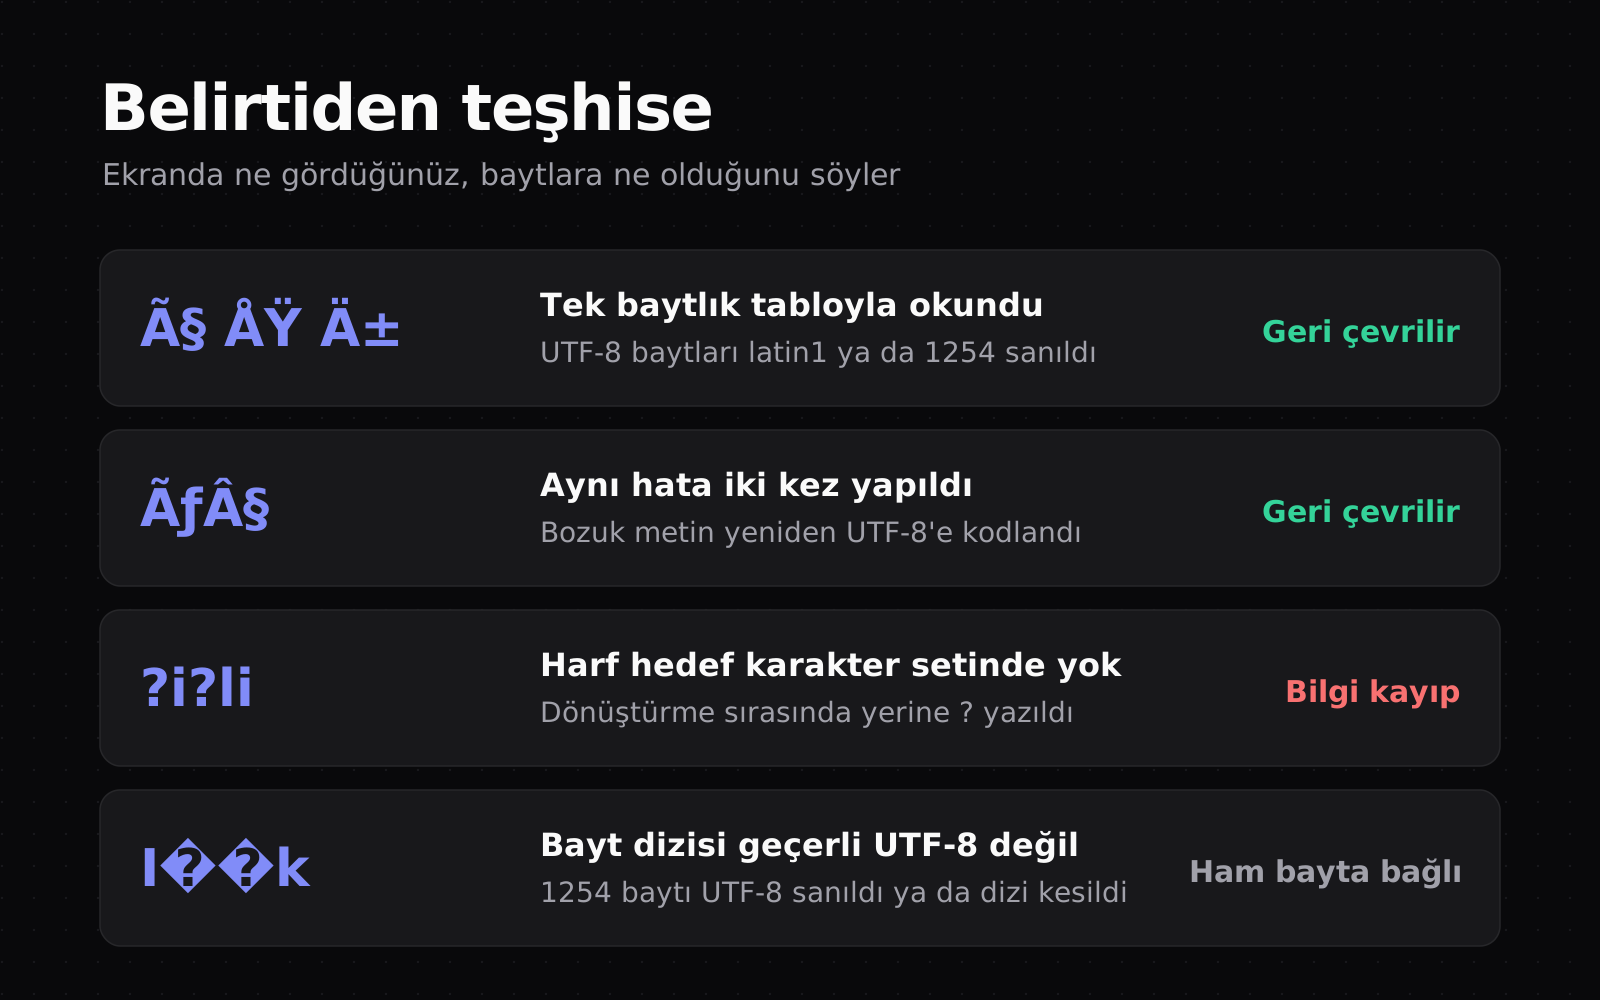
Bozuk metin bir kez daha UTF-8'e kodlanıp yine tek baytlık tabloyla okunursa çift kodlama oluşur. Her tur metni uzatır ve bozulmayı bir katman daha derine gömer:
metin = "ç"for tur in range(1, 4): metin = metin.encode("utf-8").decode("cp1252") print(tur, metin, metin.encode("utf-8").hex(" ").upper()) # Çıktı:# 1 ç C3 83 C2 A7# 2 ç C3 83 C6 92 C3 82 C2 A7# 3 ç C3 83 C6 92 C3 86 E2 80 99 C3 83 E2 80 9A C3 82 C2 A7Kaç tur yaşandığını Ã'dan sonra gelen ƒ ve Â'lardan okuyabilirsiniz. "ç" iki tur, "ç" üç tur. Katmanlar doğru sırayla soyulduğunda hepsi geri gelir, çünkü hiçbir turda bayt kaybolmadı.
Soru işareti ile "�" ise başka hikâyeler anlatır:
# 1) Hedef kod sayfasında karşılığı olmayan harf: '?' olur, bilgi kaybolurprint("Işık".encode("latin-1", errors="replace")) # 2) Windows-1254 baytları UTF-8 sanılırsa: geçersiz dizi, U+FFFD olureski = "Işık".encode("cp1254")print(eski.hex(" ").upper(), "->", eski.decode("utf-8", errors="replace")) # 3) UTF-8 dizisinin ortasından kesmek de U+FFFD üretirb = "Işık".encode("utf-8")[:2]print(b.hex(" ").upper(), "->", b.decode("utf-8", errors="replace")) # Çıktı:# b'I??k'# 49 FE FD 6B -> I��k# 49 C5 -> I�İlk satırda hedef karakter setinde ş ile ı yok ve dönüştürücü onların yerine ? yazmış. Artık I??k dizisinin "Işık" mı "Irak" mı olduğunu bilmenin yolu yok, bilgi silindi. İkinci satırda tersi oluyor. Windows-1254 ile kaydedilmiş FE FD baytları UTF-8 sanılıyor, ama FE UTF-8'de hiçbir dizinin başında yer alamaz. Unicode Standardı bozuk dizilerin yerine U+FFFD REPLACEMENT CHARACTER konmasını önerir ve ekrandaki elmas içindeki soru işareti budur. Üçüncü satır aynı işareti başka bir yoldan üretiyor: iki baytlık bir diziyi ortasından kesmek.
"�" gördüğünüzde iki soru sorun. Veri gerçekten Windows-1254 ile mi kaydedilmiş, yoksa bir yerde bayt düzeyinde mi kesiliyor? Ham baytlar duruyorsa doğru tabloyla okuyup kurtarırsınız. U+FFFD görüntülerken değil kaydederken yazıldıysa o harf de "?" gibi kaybolmuştur.
Bozulmanın çıktığı dört yer
HTTP başlığı ve meta etiketi
Tarayıcı bir HTML sayfasının kodlamasına sırayla karar verir. Önce dosyanın başında BOM arar, sonra HTTP yanıtındaki Content-Type başlığının charset parametresine bakar, en son belgenin ilk 1024 baytında <meta charset> etiketini tarar. Hiçbiri yoksa tahmin eder ya da yerel ayara göre bir varsayılan seçer. HTML standardının Türkçe için önerdiği varsayılan windows-1254. Yani UTF-8 yazılmış ama hiçbir şey ilan etmeyen bir sayfa, Türkçe Windows'taki bir tarayıcıda yukarıdaki tablonun aynısını üretebilir. Başlıkların istek ve yanıtta nasıl taşındığını HTTP yazısında anlatmıştım.
PHP 5.6'dan beri default_charset ayarı UTF-8 ve PHP ürettiği HTML yanıtlara charset'i kendisi ekliyor. Statik dosyalarda bu iş sunucuya kalıyor. Apache'nin varsayılan kurulumu text/html gönderir ve charset eklemez. .htaccess ile uzantı gizleme yazısında dosyanın nasıl çalıştığına değinmiştim, burada iki satır yetiyor:
AddDefaultCharset UTF-8AddCharset UTF-8 .css .js# .htaccess yokken$ curl -sI http://localhost/index.html | grep -i content-typeContent-Type: text/html # .htaccess varken$ curl -sI http://localhost/index.html | grep -i content-typeContent-Type: text/html; charset=UTF-8$ curl -sI http://localhost/stil.css | grep -i content-typeContent-Type: text/css; charset=utf-8<meta charset="utf-8"> etiketini de bırakmayın. Sayfa diske kaydedilip başlıksız açıldığında elinizde kalan tek beyan odur.
MySQL: tablo değil bağlantı
MySQL her bağlantı için üç değişken tutar. character_set_client sunucunun gelen sorguyu hangi kodlamada okuyacağını, character_set_connection sorguyu hangi kodlamaya çevirip işleyeceğini, character_set_results sonuçları hangi kodlamada geri yollayacağını belirler. SET NAMES x üçünü birden ayarlar.
Uygulamanız UTF-8 bayt gönderip bağlantıyı latin1 ilan ederse sunucu bu baytları latin1 harfleri sanır ve utf8mb4 kolona yazarken her birini ayrıca UTF-8'e çevirir. Sonuç çift kodlamadır, ama sinsisinden. Aynı yanlış bağlantıyla okuyan uygulama ters dönüşümü de yaptığı için her şeyi düzgün görür. Aşağıdaki deneme PHP 7.3 ve MySQL 8.0 ile:
<?phpfunction baglan($charset) { $dsn = "mysql:host=mojibake-mysql;dbname=demo;charset=$charset"; return new PDO($dsn, 'app', 'scratch', [PDO::ATTR_ERRMODE => PDO::ERRMODE_EXCEPTION]);} $eski = baglan('latin1'); // eski uygulama, kaynak dosyalar UTF-8$eski->exec("INSERT INTO adres VALUES (1, 'Kadıköy')"); $sql = 'SELECT ilce FROM adres WHERE id = 1';echo 'eski uygulama : ', $eski->query($sql)->fetchColumn(), PHP_EOL;echo 'yeni uygulama : ', baglan('utf8mb4')->query($sql)->fetchColumn(), PHP_EOL; /* Çıktı:eski uygulama : Kadıköyyeni uygulama : Kadıköy*/Bu yüzden "bizim uygulamada sorun yok, phpMyAdmin bozuk gösteriyor" cümlesi çoğu zaman tam tersini anlatır. Bozuk olan uygulamanın bağlantısıdır, phpMyAdmin yalnızca diskteki gerçeği gösteriyordur. Şüphelendiğiniz bağlantının içinden şu sorguyu çalıştırın:
SHOW VARIABLES WHERE Variable_name IN ('character_set_client', 'character_set_connection', 'character_set_results'); -- Sonuç (latin1 ilan eden bir istemciyle):-- character_set_client | latin1-- character_set_connection | latin1-- character_set_results | latin1Tartışmayı HEX() bitirir. Doğru kaydedilmiş bir ş için C59F görmeniz gerekir. C385C5B8 görüyorsanız kayıt çift kodlanmış, Å ve Ÿ harflerinin UTF-8 baytları diskte duruyor demektir. PDO'da DSN'e charset=utf8mb4 eklemek, mysqli'de set_charset('utf8mb4') çağırmak doğru yoldur. SET NAMES'i sorgu olarak göndermek sunucuyu ayarlar ama istemci kütüphanesi bundan habersiz kalır ve real_escape_string gibi fonksiyonlar eski karakter setine göre çalışmaya devam eder.
Bağlantı doğru olsa bile kolon yetmeyebilir. MySQL'in utf8'i en fazla üç baytlık karakter saklar ve emoji gibi dört baytlık karakterleri kabul etmez. Tam UTF-8 desteği 5.5.3'te utf8mb4 adıyla geldi. Nisan 2018'de çıkan MySQL 8.0 varsayılan karakter setini latin1'den utf8mb4'e çevirdi. 5.7 ve öncesiyle kurulmuş sunucularda ise ayarlarla değiştirilmediyse varsayılan hâlâ latin1.
CREATE TABLE yorum (metin VARCHAR(50)) CHARACTER SET utf8;INSERT INTO yorum VALUES ('Harika 😀');SET SESSION sql_mode = '';INSERT INTO yorum VALUES ('Harika 😀');SELECT metin, HEX(metin) FROM yorum; -- Sonuç:-- ERROR 1366 (HY000): Incorrect string value: '\xF0\x9F\x98\x80' for column 'metin' at row 1---- metin | HEX(metin)-- Harika ? | 486172696B61203FStrict mode (STRICT_TRANS_TABLES) 5.7'den beri varsayılan olarak açık ve satırı hatayla geri çeviriyor. Strict mode'u kapatılmış bir sunucuda aynı satır uyarıyla kaydediliyor ve emojinin yerinde bir soru işareti kalıyor. Latin1 bir kolona Türkçe yazmaya kalktığınızda da aynısı olur: Şişli diske ?i?li olarak düşer.
PHP: bayt sayan fonksiyonlar ve BOM
PHP'nin klasik metin fonksiyonları karakter değil bayt sayar. UTF-8'de bu fark Türkçe harflerde hemen ortaya çıkar:
<?php$ad = "Işık";var_dump(strlen($ad), mb_strlen($ad, 'UTF-8'));var_dump(bin2hex(substr($ad, 0, 2))); // "I" + ş'nin ilk baytıvar_dump(mb_substr($ad, 0, 2, 'UTF-8'));var_dump(mb_check_encoding(substr($ad, 0, 2), 'UTF-8'));var_dump(strtoupper("şiir"), mb_strtoupper("şiir", 'UTF-8')); /* Çıktı:int(6)int(4)string(4) "49c5"string(3) "Iş"bool(false)string(5) "şIIR"string(5) "ŞIIR"*/substr ş'nin ortasından kesti ve geriye geçersiz bir UTF-8 dizisi bıraktı. Bu değer sayfaya basıldığında tarayıcı onu "I�" diye gösterir. Kısaltma, uzunluk kontrolü ve büyük harfe çevirme gibi her işi mb_* karşılığıyla ve kodlamayı açıkça vererek yapın.
Uyarı
mb_strtoupper bile "şiir"i "ŞIIR" yapıyor, çünkü Unicode'un varsayılan büyük harf eşlemesi i'yi I'ya çevirir. Türkçeye özgü i/İ ve ı/I kuralı Unicode'da dile bağlı özel durum olarak tanımlıdır ve mbstring onu uygulamaz. Türkçe metni büyütmeden önce i harfini İ'ye kendiniz çevirin.BOM ise görünmez bir sorun. Dosyayı "UTF-8 BOM'lu" kaydeden bir editör, <?php etiketinden önce EF BB BF baytlarını yazar. PHP bu üç baytı sıradan çıktı sayıp tarayıcıya gönderir ve çıktı başladıktan sonra header() çalışmaz:
$ curl -s http://localhost/api.php<br /><b>Warning</b>: Cannot modify header information - headers already sent by (output started at /app/api.php:1) in <b>/app/api.php</b> on line <b>2</b><br />{"sehir":"İzmir"}Hata mesajındaki "output started at ...:1" ipucu tam olarak BOM'u gösterir, birinci satırda görünür bir çıktı yoktur. Aynı BOM bir JSON dosyasının başında olduğunda json_decode onu sözdizimi hatası sayar:
<?php$ham = file_get_contents('veri.json');var_dump(bin2hex(substr($ham, 0, 3)));var_dump(json_decode($ham), json_last_error_msg());var_dump(json_decode(preg_replace('/^\xEF\xBB\xBF/', '', $ham), true)); /* Çıktı:string(6) "efbbbf"NULLstring(12) "Syntax error"array(1) { ["sehir"]=> string(6) "İzmir"}*/Bu üç bayt yanlış tabloyla okunduğunda da kendini ele verir. Bir yanıtın ya da dosyanın başında "" görüyorsanız o, BOM'un Windows-1252 ile okunmuş hâlidir.
Excel ve CSV
Burada BOM bu kez işe yarıyor. Excel bir CSV dosyasını çift tıklamayla açarken başta BOM yoksa Windows'un ANSI kod sayfasını varsayar. Türkçe Windows'ta bu Windows-1254 demek ve BOM'suz bir UTF-8 CSV ilk tablodaki harflerle açılır. Türkçe bölge ayarında liste ayırıcısı noktalı virgül olduğundan ayırıcıyı da ; seçmek gerekir, yoksa virgülle ayrılmış dosya tek kolona yığılır:
import csv satirlar = [["ad", "şehir"], ["Çağlar", "İzmir"]] with open("musteriler.csv", "w", encoding="utf-8-sig", newline="") as f: csv.writer(f, delimiter=";").writerows(satirlar) with open("musteriler.csv", "rb") as f: print(f.read(12).hex(" ").upper()) # Çıktı:# EF BB BF 61 64 3B C5 9F 65 68 69 72Aynı dosyayı bir programa verecekseniz BOM bu sefer sorun çıkarabilir, çünkü ilk kolon adının başına \ufeff yapışır. Okurken utf-8-sig kullanmak iki durumu da karşılar: BOM varsa atar, yoksa düz UTF-8 okur.
ham = b'\xef\xbb\xbf{"sehir": "\xc4\xb0zmir"}'print(repr(ham.decode("utf-8")[:3]))print(repr(ham.decode("utf-8-sig")[:3])) # Çıktı:# '\ufeff{"'# '{"s'Bozuk veriyi geri çevirmek
Onarım, bozulmanın tersidir. Metni bozan tabloyla tekrar bayta çevirir, o baytları UTF-8 olarak okursunuz. Çift kodlamada aynı adımı her katman için tekrarlarsınız. Zor olan, ne zaman duracağınızı bilmek. Gerçek bir ğ, ş ya da ı Windows-1252'de bulunmadığı için bayta çevrilemez ve düzgün Türkçe metin bu sınavı geçemez. Geçerli UTF-8 çıkmayan bir sonuç da katmanların bittiğini gösterir.
def bayta_geri(metin): """Yanlışlıkla Windows-1252 diye okunmuş metni ham baytlara geri çevirir.""" cikti = bytearray() for harf in metin: try: cikti += harf.encode("cp1252") except UnicodeEncodeError: if 0x80 <= ord(harf) <= 0x9F: # tanımsız baytlardan gelen C1 kontrol karakterleri cikti.append(ord(harf)) else: raise return bytes(cikti) def onar(metin, en_fazla=3): for _ in range(en_fazla): try: aday = bayta_geri(metin).decode("utf-8") except (UnicodeEncodeError, UnicodeDecodeError): break # artık geri çevrilecek katman yok if aday == metin: break metin = aday return metin for ornek in ["ÇAÄžLAR", "ÅžiÅŸli", "çilek", "Ãœsküdar", "Çağlar", "café"]: print(f"{ornek:12} -> {onar(ornek)}") # Çıktı:# ÇAÄžLAR -> ÇAĞLAR# ÅžiÅŸli -> Şişli# çilek -> çilek# Ãœsküdar -> Üsküdar# Çağlar -> Çağlar# café -> café80–9F aralığı için ayrı bir dal var. Windows-1252'nin boş bıraktığı 81, 8D, 8F, 90 ve 9D baytlarını MySQL'in latin1'i aynı numaralı C1 kontrol karakterlerine çevirir. Tarayıcılar da 1254'te tanımsız olan 9E için aynısını yapar. Python'un cp1252 codec'i bu karakterleri tanımadığı için fonksiyon onları ham bayt olarak geri koyuyor.
Aynı mantık tarayıcıda da kurulur. TextDecoder Windows-1252 tablosunu zaten biliyor, tersini bir kez çıkarmak yetiyor. Kontrol karakteri dalı burada da gerekli: tarayıcı Ş'nin ikinci baytını 1254 ile U+009E diye okuyor ve 1252 tablosunda böyle bir karakter yok.
// Windows-1252 tablosunu tarayıcının kendi çözücüsünden ters çeviriyoruzconst cp1252 = new TextDecoder('windows-1252');const geriTablo = new Map();for (let b = 0; b < 256; b++) { geriTablo.set(cp1252.decode(Uint8Array.of(b)), b);}const utf8 = new TextDecoder('utf-8', { fatal: true }); function baytaGeri(metin) { const baytlar = []; for (const harf of metin) { const kod = harf.codePointAt(0); if (geriTablo.has(harf)) baytlar.push(geriTablo.get(harf)); else if (kod >= 0x80 && kod <= 0x9f) baytlar.push(kod); // C1 kontrol karakteri else return null; // gerçek Türkçe harf var } return Uint8Array.from(baytlar);} function onar(metin, enFazla = 3) { for (let i = 0; i < enFazla; i++) { const baytlar = baytaGeri(metin); if (!baytlar) return metin; let aday; try { aday = utf8.decode(baytlar); } catch (e) { return metin; // geçerli UTF-8 değil, katman bitti } if (aday === metin) return metin; metin = aday; } return metin;} // Tarayıcının Windows-1254 ile yanlış okuduğu bir metinconst bozuk = new TextDecoder('windows-1254').decode(new TextEncoder().encode('Şahin Işık'));const gorunur = bozuk.replace(/[\x80-\x9f]/g, (c) => '\\u' + c.charCodeAt(0).toString(16).padStart(4, '0'));console.log(gorunur, '->', onar(bozuk));console.log(onar('çilek'), onar('Öğretmen'), onar('Çağlar')); // Çıktı:// Å\u009eahin Işık -> Şahin Işık// çilek Öğretmen ÇağlarTek tük metinler için kod yazmanıza gerek yok, sitedeki Bozuk Türkçe Karakter Düzeltme aracı aynı ters dönüşümü tarayıcıda yapıyor ve metnin düzgün kısımlarına dokunmuyor.
Veritabanında onarım
SQL'de ters dönüşüm üç adımdan oluşur. CONVERT(ad USING latin1) sunucunun yazarken yaptığı dönüşümü geri alır, CAST(... AS BINARY) harfleri ham bayta indirir, dıştaki CONVERT(... USING utf8mb4) o baytları doğru okur. Bunu doğrudan UPDATE musteri SET ad = ... diye çalıştırmayın. Tabloda düzgün kayıtlar da varsa ifade onları da bozar. Önce sonucu yeni bir kolona yazıp bakın:
-- 1) Onarılmış değeri yeni kolona yaz, eski kolona dokunmaALTER TABLE musteri ADD COLUMN ad_yeni VARCHAR(50) CHARACTER SET utf8mb4; UPDATE musteriSET ad_yeni = CONVERT(CAST(CONVERT(ad USING latin1) AS BINARY) USING utf8mb4); -- 2) Kontrol: onarım geri bozulduğunda birebir eski değeri vermeliSELECT id, ad, ad_yeni, CONVERT(CAST(ad_yeni AS BINARY) USING latin1) = ad AS tutarliFROM musteri; -- Sonuç:-- id | ad | ad_yeni | tutarli-- 1 | ÅžiÅŸli | Şişli | 1-- 2 | Çağlar | NULL | NULL-- 3 | Işık | I??k | 0Üçüncü satıra bakın. latin1'de ş ve ı olmadığı için dönüşüm onları soru işaretine çevirmiş ve ortaya geçerli bir UTF-8 metin çıkmış. Yalnızca NULL kontrolü yapan bir onarım "Işık"ı "I??k" yapardı. Bunu tutarli kolonundaki round-trip kontrolü yakalıyor: onarılmış değer tekrar bozulduğunda birebir eski değeri vermiyorsa o satır zaten bozuk değildi. Taşımayı yalnızca tutan satırlarda yapın ve eski değeri bir yedek kolonda saklayın:
-- 3) Yalnızca tutarlı satırları taşı, eski değeri yedek kolonda tutALTER TABLE musteri ADD COLUMN ad_yedek VARCHAR(50) CHARACTER SET utf8mb4;UPDATE musteri SET ad_yedek = ad; UPDATE musteriSET ad = ad_yeniWHERE ad_yeni IS NOT NULL AND CONVERT(CAST(ad_yeni AS BINARY) USING latin1) = ad; ALTER TABLE musteri DROP COLUMN ad_yeni;SELECT * FROM musteri; -- Sonuç:-- id | ad | ad_yedek-- 1 | Şişli | ÅžiÅŸli-- 2 | Çağlar | Çağlar-- 3 | Işık | IşıkRollback betiğini de aynı anda yazın ve canlıya çıkmadan bir kopya tabloda deneyin. Yedek kolonu ancak uygulama birkaç gün yeni bağlantı ayarıyla sorunsuz çalıştıktan sonra silin.
-- Geri dönüş: yedek kolondan eski değerleri yükleUPDATE musteri SET ad = ad_yedek;ALTER TABLE musteri DROP COLUMN ad_yedek;SELECT * FROM musteri;Bir de veri hiç bozulmamış ama yanlış etiketlenmiş olabilir. Hem kolon hem bağlantı latin1 ise UTF-8 baytları dönüşmeden latin1 kolona yazılır. Uygulama düzgün görür, ama MySQL her baytı ayrı harf saydığından CHAR_LENGTH yanlış çıkar ve sıralama bozulur. Bu durumda MODIFY ... CHARACTER SET utf8mb4 yazmak hatadır. MySQL her baytı latin1 harfi sayıp dönüştürür ve çift kodlamayı bu kez siz üretmiş olursunuz. Araya dönüşümsüz bir VARBINARY durağı koyun:
SELECT ad, HEX(ad), CHAR_LENGTH(ad) FROM urun; ALTER TABLE urun MODIFY ad VARBINARY(50);ALTER TABLE urun MODIFY ad VARCHAR(50) CHARACTER SET utf8mb4; SELECT ad, HEX(ad), CHAR_LENGTH(ad) FROM urun; -- Sonuç:-- ad | HEX(ad) | CHAR_LENGTH(ad)-- Çilek reçeli | C387696C656B207265C3A7656C69 | 14---- ad | HEX(ad) | CHAR_LENGTH(ad)-- Çilek reçeli | C387696C656B207265C3A7656C69 | 12Baytlar hiç değişmedi, yalnızca etiket değişti. HEX() sütununun iki sorguda aynı kalması da bunun kanıtı.
Uçtan uca UTF-8
- Kaynak dosyalar BOM'suz UTF-8 kaydedilir. Editörün varsayılanına bir kez bakmak yeter.
- HTTP yanıtı
Content-Type: text/html; charset=utf-8taşır ve HTML'in başında<meta charset="utf-8">bulunur. - Sunucu, tablo ve kolon
utf8mb4olur. Bağlantının karakter seti DSN'de ya daset_charsetile verilir. - PHP'de çok baytlı metin işlemleri
mb_*fonksiyonlarıyla ve açık kodlamayla yapılır. - Excel'e gidecek CSV BOM'lu, programa gidecek CSV BOM'suz yazılır. Okurken
utf-8-sigkullanılır. - Sistemin sınırlarında gelen veri doğrulanır.
mb_check_encodingya dafatal: trueile kurulmuş birTextDecodergeçersiz UTF-8'i kapıda reddeder.
Sonuç
Bozuk bir harf gördüğünüzde ilk işiniz düzeltmek değil baytlara bakmak olsun. HEX(), bin2hex ya da xxd çıktısı verinin gerçekten bozuk mu yoksa yalnızca yanlış okunmuş mu olduğunu söyler ve bu iki durumun çözümü birbirinin tersidir. Yanlış okunan veriyi onarmaya kalkarsanız sağlam baytları bozarsınız.
Benim kuralım şu: kodlama her sınırda açıkça yazılır. Dosyada, HTTP başlığında, veritabanı bağlantısında, kolonda. Bir katmanı varsayılana bırakmak, onu bir gün başka bir makinenin varsayılanına bırakmak demektir.
Sıkça Sorulan Sorular
- Python 3 kullanıyorum, bu sorun bende de çıkar mı?
- Python 3'te
strUnicode'dur ama sorun sınırlarda başlar.open()kodlama verilmeden çağrıldığında işletim sisteminin tercih ettiği kodlamayı kullanır ve bu Türkçe Windows'ta cp1254'tür. Aynı betik macOS'ta UTF-8 dosyayı düzgün okurken Windows'ta bozuk okur. Dosya açarkenencodingparametresini her seferinde yazın. - Metin ekranda düzgün görünüyor ama arama "ş" harfini bulamıyor. Neden?
- Bu bir kodlama değil normalizasyon sorunu. ş tek kod noktası (U+015F) olarak da,
sile birleşik çengel işaretinin (U+0327) yan yana gelmesiyle de yazılabilir. İkisi aynı görünür ama baytları farklıdır. macOS'un HFS+ dosya sistemi gibi bazı kaynaklar harfle işareti ayrı tutan biçimi (NFD) üretir. Karşılaştırmadan önce iki tarafı da NFC'ye çevirin. Python'da bunun içinunicodedata.normalize('NFC', metin)var. - Tabloyu utf8mb4'e çevirirken "Specified key was too long" hatası alıyorum.
- InnoDB'nin eski row format'larında indeks anahtarı en fazla 767 bayt olabilir.
utf8mb4karakter başına dört bayt ayırdığı içinVARCHAR(255)bir kolonun indeksi 1020 bayta çıkar ve sınırı aşar. MySQL 5.7.7'den beriinnodb_large_prefixvarsayılan olarak açık ve DYNAMIC row format'ıyla sınır 3072 bayt. Daha eski bir sunucudaysanız ya bu ayarları açın ya da indeksli kolonuVARCHAR(191)ile sınırlayın. - API yanıtında "\u015f" gibi diziler görüyorum. Bu da bozulma mı?
- Hayır. JSON, ASCII dışındaki karakterleri
\uescape dizisiyle yazmaya izin verir ve PHP'ninjson_encodefonksiyonu bunu varsayılan olarak yapar.\u015fgeçerli bir ş'dir ve her JSON parser'ı onu doğru okur. Yanıtın okunaklı olmasını istiyorsanızJSON_UNESCAPED_UNICODEbayrağını kullanın, ama bu bir düzeltme değil tercih meselesi. - Kodlamayı otomatik tespit eden kütüphanelere güvenebilir miyim?
- Yalnızca ipucu olarak. Bu araçlar bayt sıklıklarına bakarak tahmin yürütür ve Windows-1254 ile Windows-1252'nin sekiz bayt dışında aynı olduğunu düşününce kısa bir Türkçe metinde ikisini ayırmaları zordur. Kodlamayı bilen taraf onu gönderen taraftır. Tespit aracını, kaynağı belli olmayan eski dosyaları sınıflandırırken kullanın, canlı veri akışında değil.
Kaynakça
- Ishida, R. (2018). Character encodings: Essential concepts. W3C Internationalization. https://www.w3.org/International/articles/definitions-characters/
- Microsoft. (1998). cp1254 to Unicode table (Tablo sürümü 2.01). Unicode Consortium. https://www.unicode.org/Public/MAPPINGS/VENDORS/MICSFT/WINDOWS/CP1254.TXT
- Oracle. (t.y.). Character sets, collations, Unicode. MySQL 8.0 Reference Manual. https://dev.mysql.com/doc/refman/8.0/en/charset.html
- The Unicode Consortium. (2019). The Unicode Standard, Version 12.0.0. https://www.unicode.org/versions/Unicode12.0.0/
- WHATWG. (t.y.). Encoding Standard. https://encoding.spec.whatwg.org/
- Yergeau, F. (2003). UTF-8, a transformation format of ISO 10646 (RFC 3629). Internet Engineering Task Force. https://doi.org/10.17487/RFC3629
Mustafa Kürşad Başer
Kıdemli Yazılım Mühendisi
Karmaşık sorunlara zarif çözümler üretmekten keyif alan, tutkulu bir yazılım mühendisi. Kodlamanın ötesinde, teknoloji, sanat ve insan bilincinin kesişim noktalarını keşfetmekle derinden ilgileniyor.