Derin Dalış: PostgreSQL'de Türkçe Sıralama ve Arama
 Mustafa Kürşad BAŞER
Seri: Derin Dalış: Veri Tabanı Yönetim Sistemleri · Bölüm 3/3
Veritabanı Türkçe bilmez, ona siz söylersiniz
Özet (TL;DR)
- PostgreSQL'de
lower(),upper(),ILIKEveORDER BYmetnin collation'ına göre çalışır. Türkçe kural istiyorsanıztr-TR-x-icugibi Türkçe bir collation'ı açıkça vermeniz gerekir. - Unicode'un varsayılan kuralı
İharfini küçültürkeniharfinin arkasına ayrı bir birleşik nokta ekler.'İSTANBUL'küçülünce dokuz karakter olur ve'istanbul'ile eşit çıkmaz. - Nondeterministic collation (
tr-TR-u-ks-level2) eşitliği,UNIQUEkısıtını veGROUP BY'ı harf büyüklüğünden bağımsız yapar. PostgreSQL 17'de iseLIKE,ILIKEve regex'lerle hiç çalışmaz. citextvepg_trgmsütunun collation'ına bakmaz. İkisi de harfleri veritabanının varsayılan ayarıyla küçültür,pg_trgmüstelik doğrudanLC_CTYPE'a bakar.- Sağlam düzen şu:
lower(ad COLLATE "tr-TR-x-icu")ifadesini tek birIMMUTABLEfonksiyonda toplayın, B-tree ve GIN indekslerini ona kurun, uygulamada datoLocaleLowerCase('tr-TR')ileIntl.Collator('tr')kullanın.
Müşteri arama kutusuna IŞIL ÇAĞLAR yazıyorsunuz ve tabloda duran Işıl Çağlar kaydı gelmiyor. Aynı ekrandaki şehir listesi Çanakkale, Cide, Çorum diye başlıyor, Ödemiş de Ordu'nun önüne geçmiş. Sorguda bir hata yok, WHERE lower(ad) = lower($1) ve ORDER BY ad kitaptaki gibi yazılmış. Sorun, veritabanının bu harflere hangi dilin kurallarıyla baktığında.
Docker'daki resmî postgres imajı veritabanı cluster'ını en_US.utf8 ile kurar. Siz bir şey söylemedikçe I harfinin küçüğü i olur, Ç de C harfinin aksanlı bir çeşidi sayılır. Bu yazı Derin Dalış: Veri Tabanı Yönetim Sistemleri serisinin üçüncü bölümü. İlk iki bölümde ilişkisel modeli ve SQL'i, ardından NoSQL ile farkları konuşmuştuk. Bu kez tek bir veri tipine, Türkçe metne iniyoruz. Bütün örnekleri PostgreSQL 17.0 üzerinde çalıştırdım, çıktılar olduğu gibi.
Dört harf, iki kural
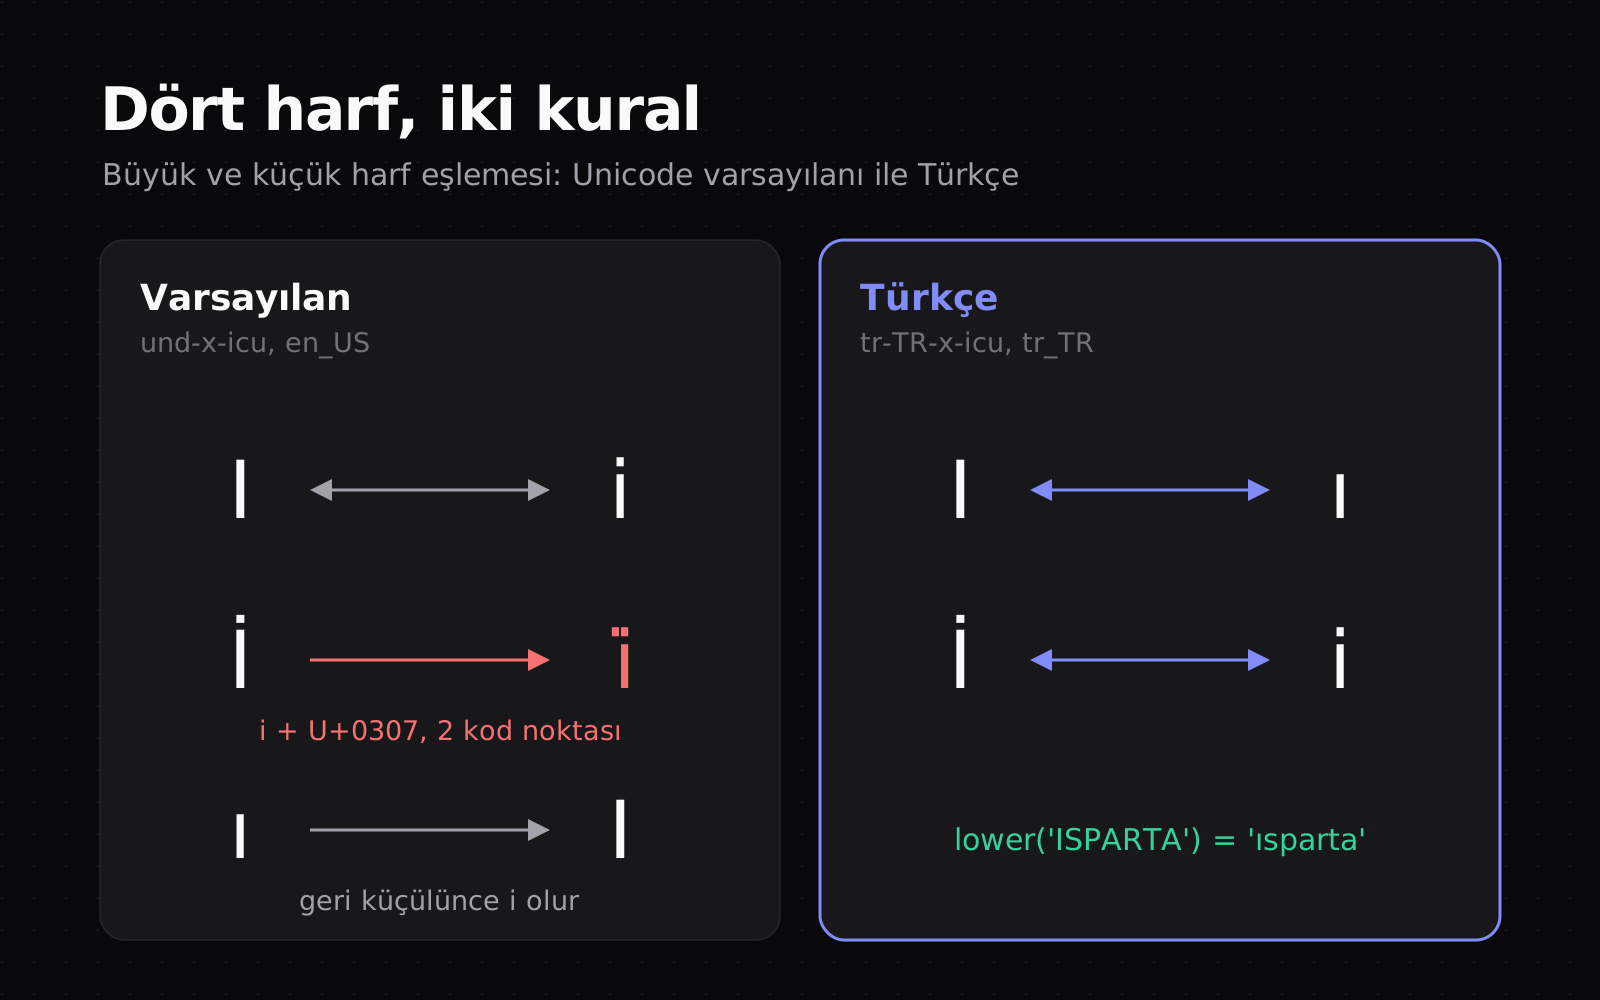
İngilizcede I ile i bir çifttir ve noktalı büyük İ alfabede yoktur. Türkçede ise iki ayrı çift var: I ile ı, İ ile i. Unicode bu farkı iki katmanda tutuyor. Herkes için geçerli varsayılan eşleme İngilizce alışkanlığa göre kurulmuş. Dile bağlı istisnalar ise Unicode 16.0 ile yayımlanan SpecialCasing.txt dosyasında, tr ve az etiketli satırlarda duruyor.
| Karakter | Varsayılan kural | Türkçe kural (tr) |
|---|---|---|
İ (U+0130) | küçüğü i + U+0307 | küçüğü i |
I (U+0049) | küçüğü i | küçüğü ı |
i (U+0069) | büyüğü I | büyüğü İ |
ı (U+0131) | büyüğü I | büyüğü I |
İlk satır işin en sinsi kısmı. Varsayılan kural İ harfini küçültürken noktayı atmıyor, i harfinin arkasına birleşik bir üst nokta (U+0307) ekliyor. Dosyadaki gerekçe kanonik eşdeğerliği korumak. Ekranda çoğu zaman fark edilmeyen bu dizi iki kod noktası tutuyor, yani küçültme işlemi metni uzatabiliyor.
lower() hangi kurala uyuyor?
PostgreSQL bu kararı fonksiyona giren metnin collation'ına bırakıyor. Dokümantasyona göre collation yalnızca sıralamayı değil lower, upper ve initcap gibi harf dönüştüren fonksiyonları ve desen eşleştirme operatörlerini de belirler. Aynı iki kelimeyi altı collation ile çevirince tablo şöyle oluyor:
-- tr_libc için işletim sisteminde tr_TR.UTF-8 yereli kurulu olmalıCREATE COLLATION IF NOT EXISTS tr_libc (provider = libc, locale = 'tr_TR.utf8'); SELECT w AS girdi, lower(w COLLATE "C") AS "C", lower(w COLLATE "en_US") AS "en_US", lower(w COLLATE tr_libc) AS tr_libc, lower(w COLLATE "und-x-icu") AS "und-x-icu", lower(w COLLATE "tr-TR-x-icu") AS "tr-TR-x-icu", lower(w COLLATE pg_c_utf8) AS pg_c_utf8FROM (VALUES ('İSTANBUL'), ('ISPARTA')) AS v(w); SELECT w AS girdi, upper(w COLLATE "C") AS "C", upper(w COLLATE "en_US") AS "en_US", upper(w COLLATE tr_libc) AS tr_libc, upper(w COLLATE "und-x-icu") AS "und-x-icu", upper(w COLLATE "tr-TR-x-icu") AS "tr-TR-x-icu", upper(w COLLATE pg_c_utf8) AS pg_c_utf8FROM (VALUES ('istanbul'), ('ısparta')) AS v(w); -- girdi | C | en_US | tr_libc | und-x-icu | tr-TR-x-icu | pg_c_utf8-- ----------+----------+----------+----------+-----------+-------------+------------- İSTANBUL | İstanbul | istanbul | istanbul | i̇stanbul | istanbul | istanbul-- ISPARTA | isparta | isparta | ısparta | isparta | ısparta | isparta---- girdi | C | en_US | tr_libc | und-x-icu | tr-TR-x-icu | pg_c_utf8-- ----------+----------+----------+----------+-----------+-------------+------------- istanbul | ISTANBUL | ISTANBUL | İSTANBUL | ISTANBUL | İSTANBUL | ISTANBUL-- ısparta | ıSPARTA | ISPARTA | ISPARTA | ISPARTA | ISPARTA | ISPARTAAltı sütunun dördü Türkçe için yanlış, her birinin yanlışı da ayrı:
Cyalnızca ASCII harflere dokunur.İveıolduğu gibi kalır, sonuçtaİstanbulveıSPARTAgibi melez kelimeler çıkar.en_US(libc) her şeyi İngilizce eşler.ISPARTAküçülünceispartaolur.und-x-icu, ICU'nun dilden bağımsız root locale'i. Unicode varsayılanını harfiyen uyguladığı içinİharfiniiartı birleşik nokta yapar.pg_c_utf8, PostgreSQL 17 ile gelenbuiltinprovider'ının collation'ı. Unicode'un basit eşlemesini kullandığı içinİharfini düziyapar ama Türkçe kuralı bilmez,Iyineiolur.
Yalnızca tr_libc ve tr-TR-x-icu doğru sonucu veriyor. İkisi arasında ben ICU'yu seçerim. libc collation'ı işletim sisteminde tr_TR.UTF-8 locale'inin kurulu olmasına bağlı. Resmî Docker imajında bu locale yok, tr_libc için önce localedef ile üretmem gerekti. ICU locale'leri ise kütüphaneyle birlikte geliyor ve aynı ICU sürümünde her işletim sisteminde aynı davranıyor. Uzunluk farkını da ölçmek gerekiyor, çünkü eşitlik karşılaştırmalarını sessizce bozan şey o:
SELECT length(lower('İSTANBUL' COLLATE "und-x-icu")) AS und_uzunluk, length(lower('İSTANBUL' COLLATE "tr-TR-x-icu")) AS tr_uzunluk, lower('İSTANBUL' COLLATE "und-x-icu") = 'istanbul' AS und_esit; -- und_uzunluk | tr_uzunluk | und_esit-- -------------+------------+------------ 9 | 8 | fORDER BY: Çanakkale neden Cide'nin önünde
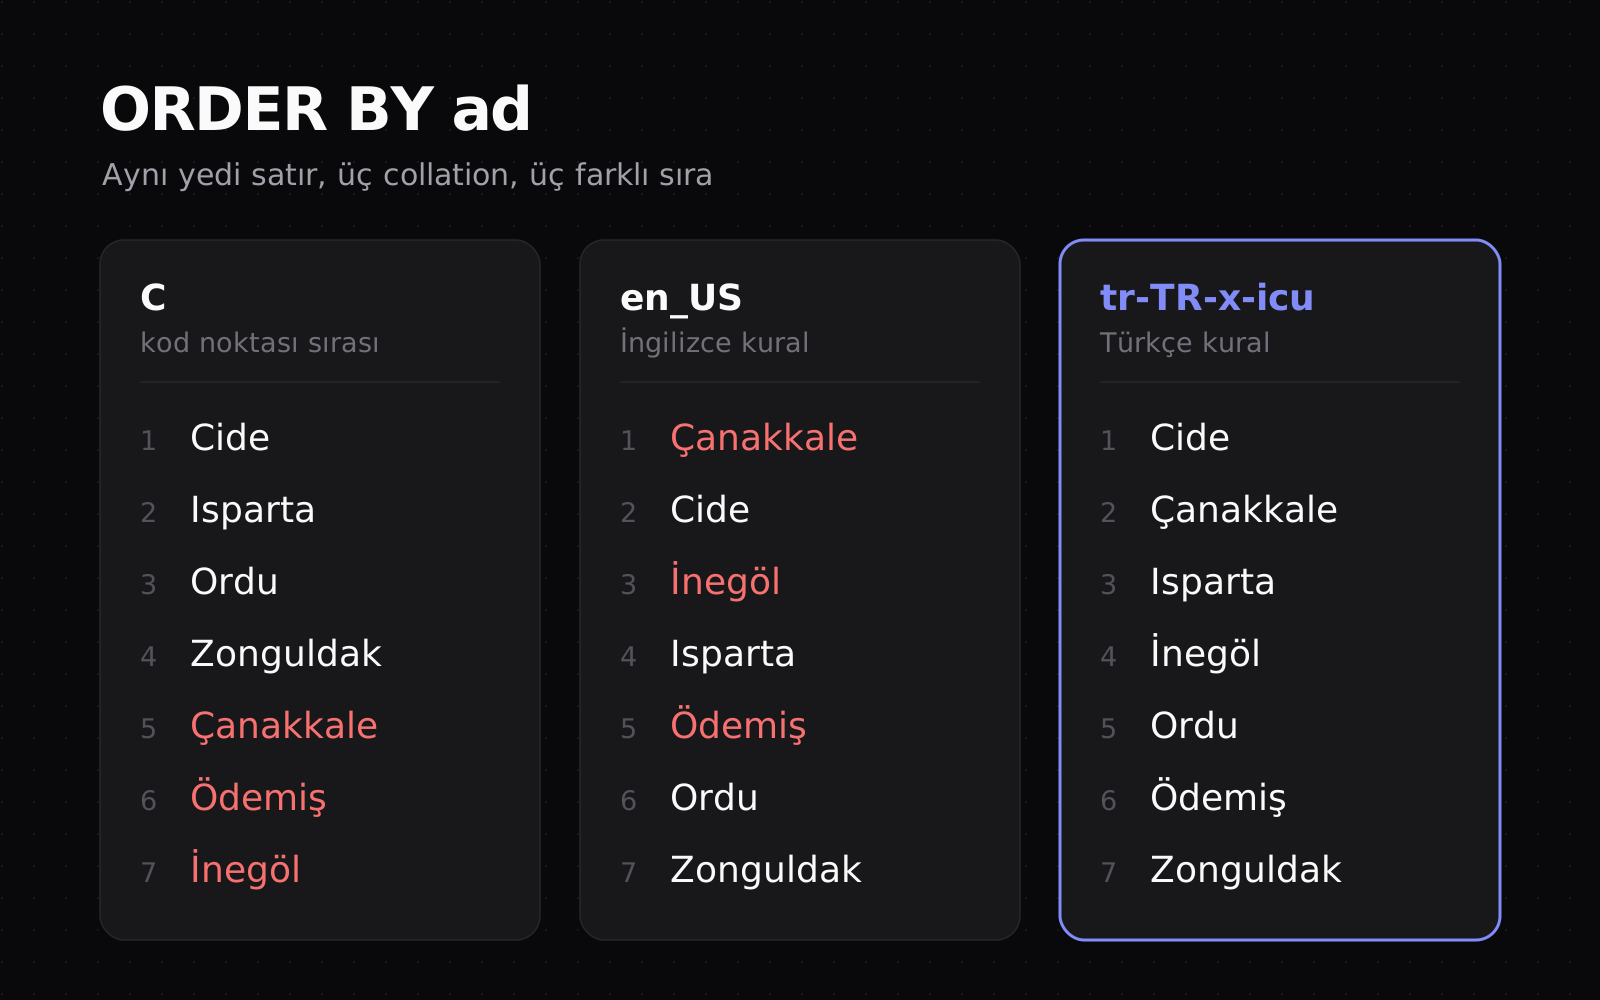
CREATE TABLE sehir (ad text);INSERT INTO sehir VALUES ('Zonguldak'), ('Çorum'), ('Ordu'), ('Şırnak'), ('Iğdır'), ('İzmir'), ('Uşak'), ('Ödemiş'), ('Sinop'), ('Ünye'), ('Isparta'), ('İnegöl'), ('Cide'), ('Çanakkale'); SELECT 'C' AS collation, string_agg(ad, ', ' ORDER BY ad COLLATE "C") AS sira FROM sehirUNION ALLSELECT 'en_US', string_agg(ad, ', ' ORDER BY ad COLLATE "en_US") FROM sehirUNION ALLSELECT 'tr-TR-x-icu', string_agg(ad, ', ' ORDER BY ad COLLATE "tr-TR-x-icu") FROM sehir; -- collation | sira-- -------------+---------------------------------------------------------------------------------------------------- C | Cide, Isparta, Iğdır, Ordu, Sinop, Uşak, Zonguldak, Çanakkale, Çorum, Ödemiş, Ünye, İnegöl, İzmir, Şırnak-- en_US | Çanakkale, Cide, Çorum, Iğdır, İnegöl, Isparta, İzmir, Ödemiş, Ordu, Sinop, Şırnak, Ünye, Uşak, Zonguldak-- tr-TR-x-icu | Cide, Çanakkale, Çorum, Iğdır, Isparta, İnegöl, İzmir, Ordu, Ödemiş, Sinop, Şırnak, Uşak, Ünye, ZonguldakC kod noktası sırasına bakar. Ç (U+00C7), Ö, Ü, İ (U+0130) ve Ş (U+015E) ASCII aralığının dışında kaldığı için hepsi Zonguldak'ın arkasına düşer. Isparta ile Iğdır'ın yer değiştirmesi de aynı nedenden: ğ (U+011F) kod noktası olarak s harfinden büyük.
en_US daha ilginç bir hata yapıyor. Unicode Collation Algorithm (UTS #10) karşılaştırmayı katman katman yürütür. Birinci düzey temel harfe, ikinci düzey aksana, üçüncü düzey büyük-küçük harfe bakar. İngilizce kuralda Ç, C harfinin aksanlı bir çeşidi sayılır ve birinci düzeyde C ile aynı ağırlığı taşır. Çanakkale ile Cide daha ilk düzeyde ikinci harfte ayrılır, a harfi i harfinden önce geldiği için Çanakkale öne geçer. Aksan farkına sıra hiç gelmez. ICU'nun Türkçe uyarlaması ise ç, ğ, ı, ö, ş ve ü harflerini birinci düzeyde ayrı harfler olarak tanımlar ve alfabe sırası yerine oturur.
Çözüm: collation'ı açıkça seçmek
PostgreSQL ICU desteğiyle derlendiyse initdb ICU locale'lerini pg_collation kataloğuna kendisi aktarır, tr-TR-x-icu hazır gelir. Daha kısa bir ad isterseniz CREATE COLLATION ile kendi collation'ınızı tanımlayabilirsiniz. Collation'ı vereceğiniz üç yer var:
-- Kendi adınızlaCREATE COLLATION tr (provider = icu, locale = 'tr-TR'); -- Sütun düzeyinde: bu sütunla ilgili her karşılaştırma ve indeks Türkçe olurCREATE TABLE sehir (ad text COLLATE "tr-TR-x-icu"); -- Sorgu düzeyinde: yalnızca bu ifade içinSELECT ad FROM sehir ORDER BY ad COLLATE "tr-TR-x-icu"; -- Veritabanı düzeyinde (PostgreSQL 15 ve sonrası)CREATE DATABASE uygulama TEMPLATE template0 LOCALE_PROVIDER icu ICU_LOCALE 'tr-TR' LOCALE 'tr_TR.utf8';Sütun düzeyi en güvenlisi, çünkü sütun üzerine kurulan B-tree indeksi de aynı collation'la oluşur. Sorgu düzeyindeki COLLATE esnek ama bir bedeli var. ad sütununun indeksi varsayılan collation'la kurulduysa ORDER BY ad COLLATE "tr-TR-x-icu" o indeksi sıralama için kullanamaz. Veritabanı düzeyindeki komutta LOCALE 'tr_TR.utf8' kısmını gözden kaçırmayın. ICU varsayılanı seçseniz bile LC_CTYPE hâlâ libc'den okunuyor ve aşağıda pg_trgm anlatılırken bunun neden önemli olduğu görülecek.
Uyarı
pg_collation.collversion ve 15'ten beri pg_database.datcollversion alanlarında sürüm tutar, uyuşmazlıkta uyarı basar. Uyarıyı gördüğünüzde önce etkilenen indeksleri REINDEX ile yeniden kurun, sonra ALTER COLLATION ... REFRESH VERSION ve ALTER DATABASE ... REFRESH COLLATION VERSION ile kaydı güncelleyin. Sırayı tersine çevirmek uyarıyı susturur ama bozuk indeksi yerinde bırakır.Büyük-küçük harfe duyarsız eşitlik: nondeterministic collation
PostgreSQL 12 ile gelen nondeterministic collation, eşitliği bayt karşılaştırmasından kurtarıyor. ICU'ya ks-level2 dediğinizde karşılaştırma ikinci düzeyde durur, yani aksanlara bakar ama harf büyüklüğünü yok sayar. Burada locale seçimi her şeyi değiştiriyor:
CREATE COLLATION tr_ci (provider = icu, locale = 'tr-TR-u-ks-level2', deterministic = false);CREATE COLLATION und_ci (provider = icu, locale = 'und-u-ks-level2', deterministic = false); SELECT a, b, a = b COLLATE und_ci AS und_ci, a = b COLLATE tr_ci AS tr_ciFROM (VALUES ('İSTANBUL', 'istanbul'), ('ISPARTA', 'ısparta'), ('ISPARTA', 'isparta'), ('ŞEKER', 'şeker'), ('şeker', 'seker')) AS v(a, b); -- a | b | und_ci | tr_ci-- ----------+----------+--------+--------- İSTANBUL | istanbul | f | t-- ISPARTA | ısparta | f | t-- ISPARTA | isparta | t | f-- ŞEKER | şeker | t | t-- şeker | seker | f | fDokümantasyondaki örnek und-u-ks-level2 ile kurulu ve Türkçe için tam ters sonuç veriyor. Root locale'de ı ayrı bir harf olduğu için ISPARTA ile ısparta eşit çıkmıyor. İ harfinin noktası da ikinci düzeyde bir aksan farkı sayıldığından İSTANBUL ile istanbul ayrışıyor. tr-TR-u-ks-level2 üç satırı da doğru bilir. Son satıra da dikkat edin: Türkçe uyarlamada ş aksanlı bir s değil, ayrı bir harf. Bu yüzden ks-level1 bile şeker ile seker arasındaki farkı silmez.
Kazanç büyük. UNIQUE kısıtı, GROUP BY, DISTINCT ve = doğrudan Türkçe kurala göre çalışıyor. Sınırı da hemen ardından geliyor:
CREATE TABLE uye ( id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY, ad text COLLATE tr_ci NOT NULL UNIQUE);INSERT INTO uye (ad) VALUES ('Işıl Çağlar');INSERT INTO uye (ad) VALUES ('IŞIL ÇAĞLAR');SELECT id, ad FROM uye WHERE ad = 'ışıl çağlar';SELECT id, ad FROM uye WHERE ad LIKE 'Işıl%';SELECT id, ad FROM uye WHERE ad ILIKE 'ışıl%';SELECT id, ad FROM uye WHERE ad ~ '^Işıl';SELECT id, ad FROM uye WHERE ad COLLATE "tr-TR-x-icu" LIKE 'Işıl%'; -- ERROR: duplicate key value violates unique constraint "uye_ad_key"-- DETAIL: Key (ad)=(IŞIL ÇAĞLAR) already exists.-- id | ad-- ----+--------------- 1 | Işıl Çağlar-- ERROR: nondeterministic collations are not supported for LIKE-- ERROR: nondeterministic collations are not supported for ILIKE-- ERROR: nondeterministic collations are not supported for regular expressions-- id | ad-- ----+--------------- 1 | Işıl ÇağlarPostgreSQL 17 nondeterministic collation ile desen eşleştirmeyi desteklemiyor. LIKE, ILIKE ve ~ doğrudan hata veriyor. Son sorgudaki gibi deterministik bir collation'ı COLLATE ile dayatarak hatadan kurtulabilirsiniz ama o noktada karşılaştırma yeniden büyük-küçük harfe duyarlı hâle gelir. Dokümantasyon iki bedel daha sayıyor: karşılaştırmalar daha yavaş, B-tree indeksler de bu collation'la tekrar eden değerleri sıkıştıramıyor (deduplication). Benim kuralım şu: nondeterministic collation'ı kimlik gibi alanlarda, yani e-posta ya da kullanıcı adının tekilliğinde kullanıyorum. Arama kutusunun arkasına koymuyorum.
Arama
ILIKE collation'ın lower()'ını kullanır
UTF-8 veritabanında ILIKE, iki tarafı ifadenin collation'ına göre lower() ile küçültüp ardından düz LIKE çalıştırıyor. PostgreSQL kaynağındaki like.c bunu açıkça yazıyor. Yani ILIKE'ın Türkçesi lower()'ınkinden ibaret:
SELECT ad, ad ILIKE 'istanbul' AS "ILIKE istanbul", ad ILIKE 'ısparta' AS "ILIKE ısparta", ad COLLATE "tr-TR-x-icu" ILIKE 'istanbul' AS "tr: istanbul", ad COLLATE "tr-TR-x-icu" ILIKE 'ısparta' AS "tr: ısparta", ad COLLATE "tr-TR-x-icu" ILIKE 'isparta' AS "tr: isparta"FROM (VALUES ('İSTANBUL'), ('ISPARTA')) AS v(ad); -- ad | ILIKE istanbul | ILIKE ısparta | tr: istanbul | tr: ısparta | tr: isparta-- ----------+----------------+---------------+--------------+-------------+--------------- İSTANBUL | t | f | t | f | f-- ISPARTA | f | f | f | t | fVarsayılan en_US altında ISPARTA ILIKE 'ısparta' yanlış dönüyor, ISPARTA ILIKE 'isparta' ise doğru. Türkçe collation verince sonuç Türkçe kurala uyuyor. Kullanıcı isparta yazdıysa bu kez kayıt bulunmuyor. Bu, bir sonraki bölümde konuşacağım aksana duyarsız aramanın gerekçesi.
citext sütunun collation'ını dinlemez
CREATE EXTENSION citext; SELECT 'ISPARTA'::citext = 'ısparta' AS "ısparta", 'ISPARTA'::citext = 'isparta' AS "isparta", ('ISPARTA'::citext COLLATE "tr-TR-x-icu") = 'isparta' AS "tr ile isparta"; -- ısparta | isparta | tr ile isparta-- ---------+---------+------------------ f | t | tSon sütun beklentiyi bozuyor. Değere COLLATE "tr-TR-x-icu" verdiğim hâlde ISPARTA yine isparta ile eşit. citext kaynağında her str_tolower çağrısı DEFAULT_COLLATION_OID ile yapılıyor, yani küçültme her zaman veritabanının varsayılan collation'ıyla. Sütunun collation'ı yalnızca küçültülmüş iki metni sıralarken devreye giriyor. Türkçe varsayılanla kurulmuş bir veritabanında citext doğru çalışır, öbür her yerde İngilizce davranır. PostgreSQL 17 dokümantasyonu da citext sayfasının başında nondeterministic collation'ı önerir.
unaccent: ş ile s'yi eşlemek ve bedeli
Kullanıcıların bir kısmı Türkçe klavye olmadan yazar: Işıl Şahin için isil sahin. Bunu yakalamak isterseniz unaccent eklentisi Türkçe harfleri Latin karşılıklarına indiriyor:
CREATE EXTENSION unaccent; SELECT unaccent('Işıl Çağlar, İğneada, Şişli, Ödemiş, Ünye') AS sonuc; SELECT a, b, unaccent(a) = unaccent(b) AS esitFROM (VALUES ('çam', 'cam'), ('kır', 'kir'), ('şiş', 'sis')) AS v(a, b); CREATE TABLE urun (ad text);CREATE INDEX ON urun (unaccent(ad)); -- sonuc-- --------------------------------------------- Isil Caglar, Igneada, Sisli, Odemis, Unye---- a | b | esit-- -----+-----+-------- çam | cam | t-- kır | kir | t-- şiş | sis | t---- ERROR: functions in index expression must be marked IMMUTABLEBurada iki ayrı sorun var. Birincisi anlamla ilgili. çam ile cam, kır ile kir farklı kelimeler ve unaccent sonrasında aynı anahtara düşüyorlar. Arama sonuçlarında fazladan satır görmek çoğu ekranda kabul edilebilir. Tekillik kontrolünde ya da eşleştirmede kabul edilemez. Aynı dönüşüm bir URL parçası üretirken ise tam istediğiniz şey. Slug Oluşturucu da Türkçe harfleri bu yüzden ASCII'ye indirir, çünkü orada amaç geri okunabilir bir adres, anlamın korunması değil.
İkincisi teknik. unaccent() fonksiyonu STABLE işaretli, çünkü sonucu search_path'teki sözlüğe ve kurallar dosyasına bağlı. Bu yüzden doğrudan indeks ifadesine giremiyor. Çözüm, sözlüğü şema adıyla sabitleyen bir wrapper fonksiyon yazmak. Birazdan onu kuracağız.
pg_trgm hangi kurala göre küçültüyor?
Trigram indeksi LIKE '%...%' aramasını hızlandırmanın standart yolu. Dokümantasyon benzerlik karşılaştırmalarının varsayılan derlemede büyük-küçük harfe duyarsız olduğunu söyler ama hangi kurala göre küçültüldüğünü söylemez. Cevap PostgreSQL 17 kaynağında duruyor. pg_trgm harfleri towlower() ile küçültüyor, o da veritabanının libc tarafındaki LC_CTYPE ayarına bakıyor. Varsayılan collation'ı ICU Türkçesi olan ama LC_CTYPE değeri en_US.utf8 kalan bir veritabanında farkı görmek mümkün:
CREATE DATABASE karma TEMPLATE template0 LOCALE_PROVIDER icu ICU_LOCALE 'tr-TR' LOCALE 'en_US.utf8'; -- \c karmaCREATE EXTENSION pg_trgm;CREATE EXTENSION citext; SELECT lower('ISPARTA') AS lower_sonucu, 'ISPARTA'::citext = 'ısparta' AS citext_esit, similarity('IŞIK', 'ışık') AS trgm_benzerlik; -- lower_sonucu | citext_esit | trgm_benzerlik-- --------------+-------------+------------------ ısparta | t | 0Aynı veritabanında lower() ve citext Türkçe konuşuyor, pg_trgm İngilizce. IŞIK ile ışık arasındaki benzerlik sıfır, çünkü I harfi i olarak küçülüyor ve hiçbir trigram eşleşmiyor. Sorgu düzeyinde COLLATE vermek de işe yaramıyor. Çaresi basit. Metni pg_trgm'ye vermeden önce Türkçe kuralla kendiniz küçültün. Ardından gelen towlower() zaten küçük olan harflere dokunmuyor.
CREATE EXTENSION pg_trgm; SELECT similarity('IŞIK' COLLATE "tr-TR-x-icu", 'ışık') AS collate_ile, similarity(lower('IŞIK' COLLATE "tr-TR-x-icu"), lower('ışık' COLLATE "tr-TR-x-icu")) AS once_lower; -- collate_ile | once_lower-- -------------+-------------- 0 | 1İndeks: aramayı ifadenin kendisine kurmak
Buraya kadarki bulgular tek bir arama anahtarında buluşuyor, o da lower(ad COLLATE "tr-TR-x-icu"). Eşitlik için B-tree, içerik araması için GIN trigram indeksini bu ifadeye kuruyoruz. 200 bin satırlık örnek bir tabloyla:
CREATE TABLE musteri ( id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY, ad text NOT NULL);INSERT INTO musteri (ad)SELECT (ARRAY['Işıl','İlker','Çağlar','Şule','Ödül','Ümit','Ilgaz','İpek','Gülşen','Ozan'])[1 + i % 10] || ' ' || (ARRAY['Yılmaz','Öztürk','Şahin','Çelik','Işık','Doğan','Aydın','Güneş'])[1 + (i / 10) % 8] || ' ' || iFROM generate_series(1, 200000) AS i; CREATE INDEX musteri_ad_tr_lower ON musteri (lower(ad COLLATE "tr-TR-x-icu"));CREATE INDEX musteri_ad_tr_trgm ON musteri USING gin (lower(ad COLLATE "tr-TR-x-icu") gin_trgm_ops);ANALYZE musteri;EXPLAIN (COSTS OFF)SELECT id, ad FROM musteriWHERE lower(ad COLLATE "tr-TR-x-icu") = lower('IŞIL IŞIK 40' COLLATE "tr-TR-x-icu"); EXPLAIN (COSTS OFF)SELECT id, ad FROM musteriWHERE lower(ad) = lower('IŞIL IŞIK 40'); EXPLAIN (COSTS OFF)SELECT id, ad FROM musteriWHERE lower(ad COLLATE "tr-TR-x-icu") LIKE '%' || lower('ŞAHİN 1999' COLLATE "tr-TR-x-icu") || '%'; SELECT id, ad FROM musteriWHERE lower(ad COLLATE "tr-TR-x-icu") LIKE '%' || lower('ŞAHİN 1999' COLLATE "tr-TR-x-icu") || '%'ORDER BY ad COLLATE "tr-TR-x-icu"; -- Index Scan using musteri_ad_tr_lower on musteri-- Index Cond: (lower((ad)::text) = 'ışıl ışık 40'::text COLLATE "tr-TR-x-icu")---- Gather-- Workers Planned: 1-- -> Parallel Seq Scan on musteri-- Filter: (lower(ad) = 'işil işik 40'::text)---- Bitmap Heap Scan on musteri-- Recheck Cond: (lower((ad)::text) ~~ '%şahin 1999%'::text COLLATE "tr-TR-x-icu")-- -> Bitmap Index Scan on musteri_ad_tr_trgm-- Index Cond: (lower((ad)::text) ~~ '%şahin 1999%'::text COLLATE "tr-TR-x-icu")---- id | ad-- --------+----------------------- 199942 | Çağlar Şahin 199942-- 199948 | Gülşen Şahin 199948-- 199946 | Ilgaz Şahin 199946-- 199940 | Işıl Şahin 199940-- 199941 | İlker Şahin 199941-- 199947 | İpek Şahin 199947-- 199949 | Ozan Şahin 199949-- 199944 | Ödül Şahin 199944-- 199943 | Şule Şahin 199943-- 199945 | Ümit Şahin 199945İkinci plan, COLLATE unutulduğunda ne olduğunu gösteriyor. İfade indeksle birebir aynı olmadığı için planlayıcı tabloyu baştan sona tarıyor, üstelik aranan değer işil işik 40 olarak küçülüyor ve doğru kaydı hiç bulamıyor. Hem yavaş hem yanlış. Son sorgunun döndürdüğü sıra da Türk alfabesine uyuyor: Ilgaz, Işıl, İlker, İpek ve sonda Ödül, Şule, Ümit.
Bilgi
'%' || $1 || '%' diye birleştiriyorsanız girdideki % ve _ karakterleri de desen olarak yorumlanır. Bu iki karakterin ve \ karakterinin önüne birer \ koyarak gönderin.Tek kaynaktan arama anahtarı
Aynı ifadeyi her sorguya elle yazmak, birinin bir gün COLLATE kısmını unutması demek. Ben ifadeyi IMMUTABLE bir fonksiyona taşıyıp indeksi ve sorguyu o fonksiyon üzerinden yazmayı tercih ederim. Aksana duyarsız arama için ikinci bir fonksiyon, unaccent sözlüğünü şema adıyla sabitliyor:
CREATE FUNCTION arama_anahtari(t text) RETURNS text LANGUAGE sql IMMUTABLE PARALLEL SAFE STRICT RETURN lower(t COLLATE "tr-TR-x-icu"); CREATE FUNCTION gevsek_anahtar(t text) RETURNS text LANGUAGE sql IMMUTABLE PARALLEL SAFE STRICT RETURN public.unaccent('public.unaccent'::regdictionary, lower(t COLLATE "tr-TR-x-icu")); CREATE INDEX musteri_gevsek_trgm ON musteri USING gin (gevsek_anahtar(ad) gin_trgm_ops);ANALYZE musteri; SELECT arama_anahtari('IŞIL ÇAĞLAR') AS arama_anahtari, gevsek_anahtar('IŞIL ÇAĞLAR') AS gevsek_anahtar; EXPLAIN (COSTS OFF)SELECT id, ad FROM musteriWHERE gevsek_anahtar(ad) LIKE '%' || gevsek_anahtar('isil sahin 19994') || '%'; SELECT id, ad FROM musteriWHERE gevsek_anahtar(ad) LIKE '%' || gevsek_anahtar('isil sahin 19994') || '%'; -- arama_anahtari | gevsek_anahtar-- ----------------+------------------ ışıl çağlar | isil caglar---- Bitmap Heap Scan on musteri-- Recheck Cond: (gevsek_anahtar(ad) ~~ '%isil sahin 19994%'::text)-- -> Bitmap Index Scan on musteri_gevsek_trgm-- Index Cond: (gevsek_anahtar(ad) ~~ '%isil sahin 19994%'::text)---- id | ad-- --------+--------------------- 199940 | Işıl Şahin 199940IMMUTABLE işareti, aynı girdiye her zaman aynı çıktının döneceğine dair verdiğiniz bir söz. ICU sürümü değişirse lower() sonucu da değişebilir, bu durumda bu indeksleri de REINDEX listesine eklemeniz gerekir. Kullanıcı isil sahin yazdığında kayıt geliyor. Anlam kaybını kabul ettiğiniz yer de tam olarak burası, bu yüzden aksansız anahtarı yalnızca arama kutusunda kullanıyorum.
Uygulama katmanı da aynı dili konuşmalı
Veritabanını Türkçe yaptınız. Frontend'de bir toLowerCase() unutulduysa aynı hata bu kez tarayıcıda, kullanıcının yazdığı harfle veritabanına giden harf arasında yeniden ortaya çıkar. JavaScript tarafında ECMA-402, yani Intl spesifikasyonu, locale'e duyarlı karşılıkları tanımlıyor:
const ad = 'İSTANBUL';console.log(ad.toLowerCase(), ad.toLowerCase().length);console.log(ad.toLocaleLowerCase('tr-TR'), ad.toLocaleLowerCase('tr-TR').length);console.log('ısparta'.toUpperCase(), 'istanbul'.toLocaleUpperCase('tr-TR'));console.log('ISPARTA'.toLocaleLowerCase('tr-TR')); const sehirler = ['Zonguldak', 'Çorum', 'Ordu', 'Şırnak', 'Iğdır', 'İzmir', 'Uşak', 'Ödemiş', 'Sinop', 'Ünye', 'Isparta', 'İnegöl', 'Cide', 'Çanakkale'];console.log([...sehirler].sort().join(', '));const tr = new Intl.Collator('tr');console.log([...sehirler].sort(tr.compare).join(', ')); const ci = new Intl.Collator('tr', { sensitivity: 'accent' });for (const [a, b] of [['İSTANBUL', 'istanbul'], ['ISPARTA', 'ısparta'], ['ISPARTA', 'isparta'], ['şeker', 'seker']]) { console.log(a, b, ci.compare(a, b) === 0);} // i̇stanbul 9// istanbul 8// ISPARTA İSTANBUL// ısparta// Cide, Isparta, Iğdır, Ordu, Sinop, Uşak, Zonguldak, Çanakkale, Çorum, Ödemiş, Ünye, İnegöl, İzmir, Şırnak// Cide, Çanakkale, Çorum, Iğdır, Isparta, İnegöl, İzmir, Ordu, Ödemiş, Sinop, Şırnak, Uşak, Ünye, Zonguldak// İSTANBUL istanbul true// ISPARTA ısparta true// ISPARTA isparta false// şeker seker falseÇıktılar PostgreSQL'dekilerle satır satır örtüşüyor. toLowerCase() tıpkı und-x-icu gibi dokuz karakterlik bir dizi üretiyor. Karşılaştırma fonksiyonu verilmemiş sort() UTF-16 kod birimlerine bakıyor ve C collation'ın sırasını veriyor. sensitivity: 'accent' ise ks-level2 ile aynı düzeyde duruyor. Eşleşmeleri bir tabloda toplarsak:
| PostgreSQL | JavaScript |
|---|---|
lower(x COLLATE "tr-TR-x-icu") | x.toLocaleLowerCase('tr-TR') |
upper(x COLLATE "tr-TR-x-icu") | x.toLocaleUpperCase('tr-TR') |
ORDER BY x COLLATE "tr-TR-x-icu" | dizi.sort(new Intl.Collator('tr').compare) |
locale = 'tr-TR-u-ks-level2', deterministic = false | new Intl.Collator('tr', { sensitivity: 'accent' }) |
locale = 'tr-TR-u-kn' | new Intl.Collator('tr', { numeric: true }) |
İki taraf da ICU kullansa bile sürümleri farklı olabilir. Nadir karakterlerde iki sıra birbirinden ayrılabilir. Sayfalamayı veritabanı yapıyorsa sıralamayı da veritabanına bırakın. İstemcide yeniden sıralanan bir sayfa, bir sonraki sayfanın başıyla çakışabilir. İstemci tarafında Intl.Collator'ı yalnızca veritabanına hiç gitmeyen listelerde kullanın.
Sonuç
Türkçe metin tutan her sütun için iki kararı yazılı hâle getirin: hangi collation ile sıralanacak ve hangi fonksiyonla arama anahtarına çevrilecek. İlki sütunun tanımında COLLATE "tr-TR-x-icu" olarak, ikincisi bir IMMUTABLE fonksiyon olarak dursun. Uygulama kodu da aynı iki kararı Intl.Collator('tr') ve toLocaleLowerCase('tr-TR') ile tekrarlasın. Varsayılana güvenmek, kararı veritabanı kurulumunu yapan kişiye bırakmak demek. O kişi de büyük ihtimalle en_US.utf8 seçmiştir.
Sıkça Sorulan Sorular
- Dolu bir tablonun sütun collation'ını değiştirmek tabloyu yeniden yazar mı?
- Hayır, ama indeksleri yeniden kurar. PostgreSQL 17.0'da
ALTER TABLE t_rw ALTER COLUMN ad TYPE text COLLATE "tr-TR-x-icu"sonrasında tablonunpg_relation_filenodedeğeri aynı kaldı (16801), indeksinki 16806'dan 16807'ye geçti. Komut yine deACCESS EXCLUSIVEkilit alır ve indeks kurulumu bitene kadar tabloya okuma da yazma da yapılamaz. Büyük tablolarda bunu bakım penceresine koyun. - Adres listesinde `Sokak 10` neden `Sokak 2`'nin önüne geçiyor?
- Collation rakamları da karakter karakter karşılaştırır ve
1karakteri2'den önce gelir. ICU'nunknseçeneği rakam dizilerini sayı olarak okur:CREATE COLLATION tr_sayisal (provider = icu, locale = 'tr-TR-u-kn')ile sıraSokak 1, Sokak 2, Sokak 10olur. JavaScript karşılığınew Intl.Collator('tr', { numeric: true }). - `initcap()` Türkçe adları doğru büyütür mü?
- Collation Türkçeyse evet.
initcap('ışıl ilker' COLLATE "tr-TR-x-icu")sonucuIşıl İlker,und-x-icuile sonuçIşıl Ilker. Kayıt formlarında adı otomatik düzelten bir trigger yazıyorsanız collation'ı fonksiyon çağrısının içinde verin, oturumun ya da veritabanının ayarına bırakmayın. - Azerbaycanca metinde de aynı tuzak var mı?
- Büyük-küçük harf tarafında evet.
SpecialCasing.txtiçindeki noktalı ve noktasız i kurallarıtrveaziçin aynı satırlarla tanımlı. Sıralama ise ayrı, çünkü Azerbaycan alfabesindeə,q,xgibi Türkçede olmayan harfler var. Bu metinler içinaz-x-icucollation'ını kullanın,pg_collationkataloğunda hazır gelir.
Kaynakça
- Ecma International. (2024). ECMAScript 2024 internationalization API specification (11. bs., ECMA-402). https://www.ecma-international.org/wp-content/uploads/ECMA-402_11th_edition_june_2024.pdf
- ICU Project. (t.y.). Collation. ICU Documentation. https://unicode-org.github.io/icu/userguide/collation/
- PostgreSQL Global Development Group. (t.y.-a). Collation support. PostgreSQL 17 Documentation. https://www.postgresql.org/docs/17/collation.html
- PostgreSQL Global Development Group. (t.y.-b). pg_trgm: Support for similarity of text using trigram matching. PostgreSQL 17 Documentation. https://www.postgresql.org/docs/17/pgtrgm.html
- Unicode Consortium. (2024). The Unicode Standard, Version 16.0.0. https://www.unicode.org/versions/Unicode16.0.0/
- Whistler, K., ve Scherer, M. (2024). Unicode collation algorithm (Unicode Technical Standard #10, Revision 51). Unicode Consortium. https://www.unicode.org/reports/tr10/tr10-51.html
Mustafa Kürşad Başer
Kıdemli Yazılım Mühendisi
Karmaşık sorunlara zarif çözümler üretmekten keyif alan, tutkulu bir yazılım mühendisi. Kodlamanın ötesinde, teknoloji, sanat ve insan bilincinin kesişim noktalarını keşfetmekle derinden ilgileniyor.