pgvector ve Meilisearch ile Hibrit Arama: Türkçe Sorgularda RRF
 Mustafa Kürşad BAŞER
Skoru Değil Sırayı Birleştirin
Özet (TL;DR)
- Meilisearch kök bulmaz. Türkçede eşleşme ön ek aramasına ve yazım hatası toleransına kalır:
faturamısorgusufaturasıkelimesini tek harflik bir hata sayarak bulur,faturalarise "Fatura iptali" başlığını hiç bulmaz. - Yazım hatası toleransı ürün kodunu da esnetir. Varsayılan ayarlarla
AX-88231aramasıAX-88232sayfasını 0,832 skorla getirir. Sayılarda toleransı kapatandisableOnNumbersayarı Meilisearch 1.15'ten beri var. - RRF yalnızca sıraya bakar ve her listeden
1/(k + sıra)puan toplar. Skorları aynı ölçeğe getirmek gerekmez, ama iki listenin ortak gürültüsü de aynı şekilde ödüllendirilir. Listeleri birleştirmeden önce düzeltin. - pgvector'da HNSW,
LIMIT 100yazsanız da varsayılanhnsw.ef_search = 40yüzünden en fazla 40 aday döndürür. Filtreli sorguda sayı daha da düşer. 0.8.0'dan berihnsw.iterative_scanbu açığı kapatıyor. - Birleştirme ayarını ortalama bir sayıya bakarak yapmayın. Sorgu türüne göre etiketlenmiş küçük bir sette sorgu başına sonuca bakın, ortalamanın sakladığı kaybı orada görürsünüz.
Diyelim ki bir destek sitesinin arama kutusuna AX-88231 şarj kutusu yazıldı. Vektör araması ilk sıraya genel bir "kulaklık şarj sorunları" yazısını koyuyor, istenen belge üçüncü sırada kalıyor. Meilisearch doğru belgeyi birinci getiriyor ama hemen arkasına başka bir modelin, AX-88232'nin sayfasını ekliyor. Aynı sitede "paketim gelmedi" yazan kullanıcıya ise Meilisearch hiçbir şey döndürmüyor, çünkü belgelerin hiçbirinde ne "paket" geçiyor ne "gelmedi".
LayeredMindAI'da bu iki motor zaten yan yana duruyor. Embedding'ler PostgreSQL'de pgvector ile tutuluyor, tam metin araması Meilisearch'te. Böyle bir kurulumda soru kaçınılmaz: kullanıcıya hangisinin listesini göstereceksiniz? Benim cevabım ikisini birden, ama skorlarıyla değil sıralarıyla birleştirerek.
İki arama nerede ayrışıyor
Meilisearch: kök yok, ön ek ve yazım hatası var
Meilisearch metni charabia adlı tokenizer'dan geçirir. Latin alfabesi için yaptığı normalizasyon, harfleri bileşenlerine ayırıp aksan işaretlerini atmak ve küçük harfe çevirmektir. Türkçede bunun sonucu şu: ç, ğ, ö, ş ve ü harfleri c, g, o, s ve u'ya iner. Noktasız ı için charabia'da ayrıca küçük bir Türkçe normalizer var ve onu i'ye çeviriyor. Böylece isik, IŞIK ve ışıklı sorgularının üçü de "Işıklı klavye ayarları" başlığını buluyor.
Kötü haber şu ki Meilisearch kök bulma (stemming) yapmıyor. Eşleşme tam kelime üzerinden yürüyor, ön ek araması (prefix search) da yalnızca sorgunun son kelimesine uygulanıyor. Eklemeli bir dilde bu, sonucu sık sık tesadüfe bırakıyor. Aşağıdaki sonuçları altı belgelik küçük bir dizinde, Meilisearch 1.44 ve varsayılan ayarlarla aldım:
| Sorgu | Dönen belge (skor) | Neden |
|---|---|---|
isik | Işıklı klavye ayarları (0,962) | ı → i, ş → s, ardından ön ek eşleşmesi |
fatura | Fatura iptali (0,985), Faturalarınızı e-posta ile almak (0,962) | fatura, faturalarınızı kelimesinin ön eki |
faturalar | Yalnızca Faturalarınızı e-posta ile almak (0,975) | fatura, faturalar sorgusunun ön eki değil, tersi gerekir |
faturamı | Fatura iptali (0,235) | faturamı ile gövdedeki faturası arasında tek harf fark var, yazım hatası sayıldı |
vatura | Hiçbiri | İlk harfteki hata iki hata sayılır, altı harfli kelimenin bir hata hakkı var |
AX-88231 | AX-88231 (0,999), AX-88232 (0,832) | 88231 beş karakter, bir hata hakkı var |
faturamı satırı dikkat istiyor. Sonuç doğru ama doğru olmasının sebebi yanlış. Meilisearch iyelik ekini tanımadı, "mı" ile "sı" arasındaki farkı yazım hatası saydı ve bunun bedeli 0,235'lik bir skor oldu. Ek iki harf daha uzun olsaydı eşleşme kaybolacaktı. Hata hakkının kuralları belli: beş harften kısa kelimeye hata hakkı yok, 5 ile 8 harf arasına bir, 9 ve üstüne iki hata tanınıyor. İlk harfteki hata iki hata sayılıyor.
Ürün kodlarında aynı kural ters tepiyor. 88231 beş karakter, yani bir hata hakkı var ve 88232 bu hakkı kullanarak eşleşiyor. showRankingScoreDetails açıldığında bu, AX-88232 için typoCount: 1 olarak görünüyor. Uzun JSON çıktısını JSON formatlayıcı ile okumak kolaylaşır. 1.15 sürümünden beri typoTolerance.disableOnNumbers sayılarda toleransı kapatıyor:
docker run -d --name pg -e POSTGRES_PASSWORD=x -p 5432:5432 pgvector/pgvector:0.8.2-pg18docker run -d --name meili -p 7700:7700 getmeili/meilisearch:v1.44.0 curl -s -X POST 'http://localhost:7700/indexes/belgeler/search' \ -H 'Content-Type: application/json' \ --data-binary '{"q": "AX-88231", "showRankingScore": true}'# (id, _rankingScore): [(3, 0.999), (4, 0.832)] curl -s -X PATCH 'http://localhost:7700/indexes/belgeler/settings/typo-tolerance' \ -H 'Content-Type: application/json' \ --data-binary '{"disableOnNumbers": true}' # aynı arama: [(3, 0.999), (4, 0.492)]# aynı arama, "matchingStrategy": "all": [(3, 0.999)]Ayardan sonra AX-88232 hâlâ listede, ama 0,492 skorla. Bu kez yalnızca ax kelimesi eşleşiyor, çünkü varsayılan matchingStrategy: "last" yeterli sonuç bulamayınca sorgunun sonundaki kelimeleri tek tek düşürüyor. "all" verildiğinde AX-88232 listeden tamamen çıkıyor. Kodlar ayrı bir alanda duruyorsa disableOnAttributes ile toleransı yalnızca o alanda kapatmak daha ince bir çözüm.
Embedding: anlamı bulur, kodu karıştırır
Embedding modeli metni sabit uzunlukta bir vektöre çevirir, iki metnin yakınlığı da bu vektörlerin arasındaki açıyla ölçülür. "Paketim gelmedi" ile "kargo gecikmesi" arasında ortak tek kelime yok, ama iyi bir çok dilli modelde bu iki ifadenin vektörleri birbirine yakın düşer. Meilisearch'ün boş döndüğü sorgu, vektör aramasının en rahat ettiği sorgudur. Türkçe ekler de bu tarafta sorun olmaktan çıkar.
Tersi de doğru. AX-88231 ile AX-88232, çoğu modelin gözünde neredeyse aynı metindir. Model kodu alt parçalara böler ve tek hanelik farkın vektöre etkisi küçük kalır. Ürün kodu, sipariş numarası, IBAN, şube ya da kişi adı gibi tam eşleşme isteyen sorgularda vektör araması doğru belgeyi bulsa bile onu komşularından ayıramaz.
| Sorgu türü | Örnek | Meilisearch | Vektör araması |
|---|---|---|---|
| Kod, numara | AX-88231, TR-2024-118 | Bulur, yakın kodları da getirebilir | Komşu kodlardan ayıramaz |
| Özel ad | Kadıköy şubesi | Bulur | Benzer adları karıştırabilir |
| Ekli kelime | faturalarımı | Ön eke ve tesadüfe kalır | Etkilenmez |
| Doğal dil | paketim gelmedi | Ortak kelime yoksa boş döner | Güçlü |
| Yazım hatası | fatüra, kulaklik | Normalizasyon ve hata hakkıyla bulur | Modele göre değişir |
Reciprocal Rank Fusion: skor yerine sıra
İki listeyi birleştirmenin ilk akla gelen yolu skorları toplamaktır ve sorun tam orada başlar. Meilisearch'ün _rankingScore değeri kendi sıralama kurallarının (kelime, yazım hatası, yakınlık, alan, konum, tam eşleşme) bir bileşimidir. pgvector ise bir mesafe döndürür. İkisi aynı ölçekte değildir, aynı sorgu için bile aynı dağılıma sahip değildir.
Cormack, Clarke ve Büttcher'in 2009'da SIGIR'da yayımladığı iki sayfalık bildirideki yöntem bu sorunu hiç kurmuyor. Her belge, içinde göründüğü her listeden 1 / (k + sıra) puan alıyor ve puanlar toplanıyor: RRF(d) = Σ 1 / (k + r(d)). Sıra 1'den başlıyor, listede olmayan belge o listeden puan almıyor.
k = 60 değeri makalede bir pilot denemede seçilmiş ve sonraki doğrulamalarda hiç değiştirilmemiş. Pilot tablosu okumaya değer: k = 0 için MAP 0,2072, k = 60 için 0,2145, k = 500 için 0,2098. 20 ile 100 arasındaki bütün değerler birbirine çok yakın, en yüksek değer bile 60'ta değil 80'de (0,2147). Yazarlar da 60'ın neredeyse en iyi olduğunu ama seçimin kritik olmadığını yazıyor. Yani 60 sihirli bir sayı değil, düz bir platonun ortasından alınmış makul bir değer.
k'nin işi üst sıraların ağırlığını yumuşatmak. k = 60 iken birinci sıra 1/61 ≈ 0,0164, onuncu sıra 1/70 ≈ 0,0143 puan alıyor, aradaki fark yüzde 15 kadar. Buna karşılık iki listede de beşinci olan bir belge 2/65 ≈ 0,0308 alıyor ve yalnızca bir listede birinci olan belgeyi rahatça geçiyor. RRF'nin asıl söylediği bu: iki bağımsız sistemin üzerinde anlaştığı belge, birinin çok beğendiği belgeden önce gelir.
from collections import defaultdict def rrf(listeler, k=60, agirliklar=None): """listeler: her biri en iyiden kötüye sıralı belge kimlikleri.""" agirliklar = agirliklar or [1.0] * len(listeler) skor = defaultdict(float) for liste, w in zip(listeler, agirliklar): for sira, belge in enumerate(liste, start=1): # sıra 1'den başlar skor[belge] += w / (k + sira) # eşitlikte kimliğe göre sırala ki sonuç her çalıştırmada aynı olsun return sorted(skor.items(), key=lambda x: (-x[1], x[0])) # "AX-88231 şarj kutusu sıfırlama" sorgusu için iki listemeili = ["ax88231-sarj-sifirlama", "ax88231-garanti", "ax88232-kablo", "sarj-kutusu-temizlik"]vektor = ["kulaklik-sarj-sorunlari", "sarj-kutusu-temizlik", "ax88231-sarj-sifirlama", "bluetooth-eslestirme", "ax88232-kablo"] if __name__ == "__main__": for belge, s in rrf([meili, vektor]): print(f"{s:.5f} {belge}") # $ python3 rrf.py# 0.03227 ax88231-sarj-sifirlama# 0.03175 sarj-kutusu-temizlik# 0.03126 ax88232-kablo# 0.01639 kulaklik-sarj-sorunlari# 0.01613 ax88231-garanti# 0.01562 bluetooth-eslestirme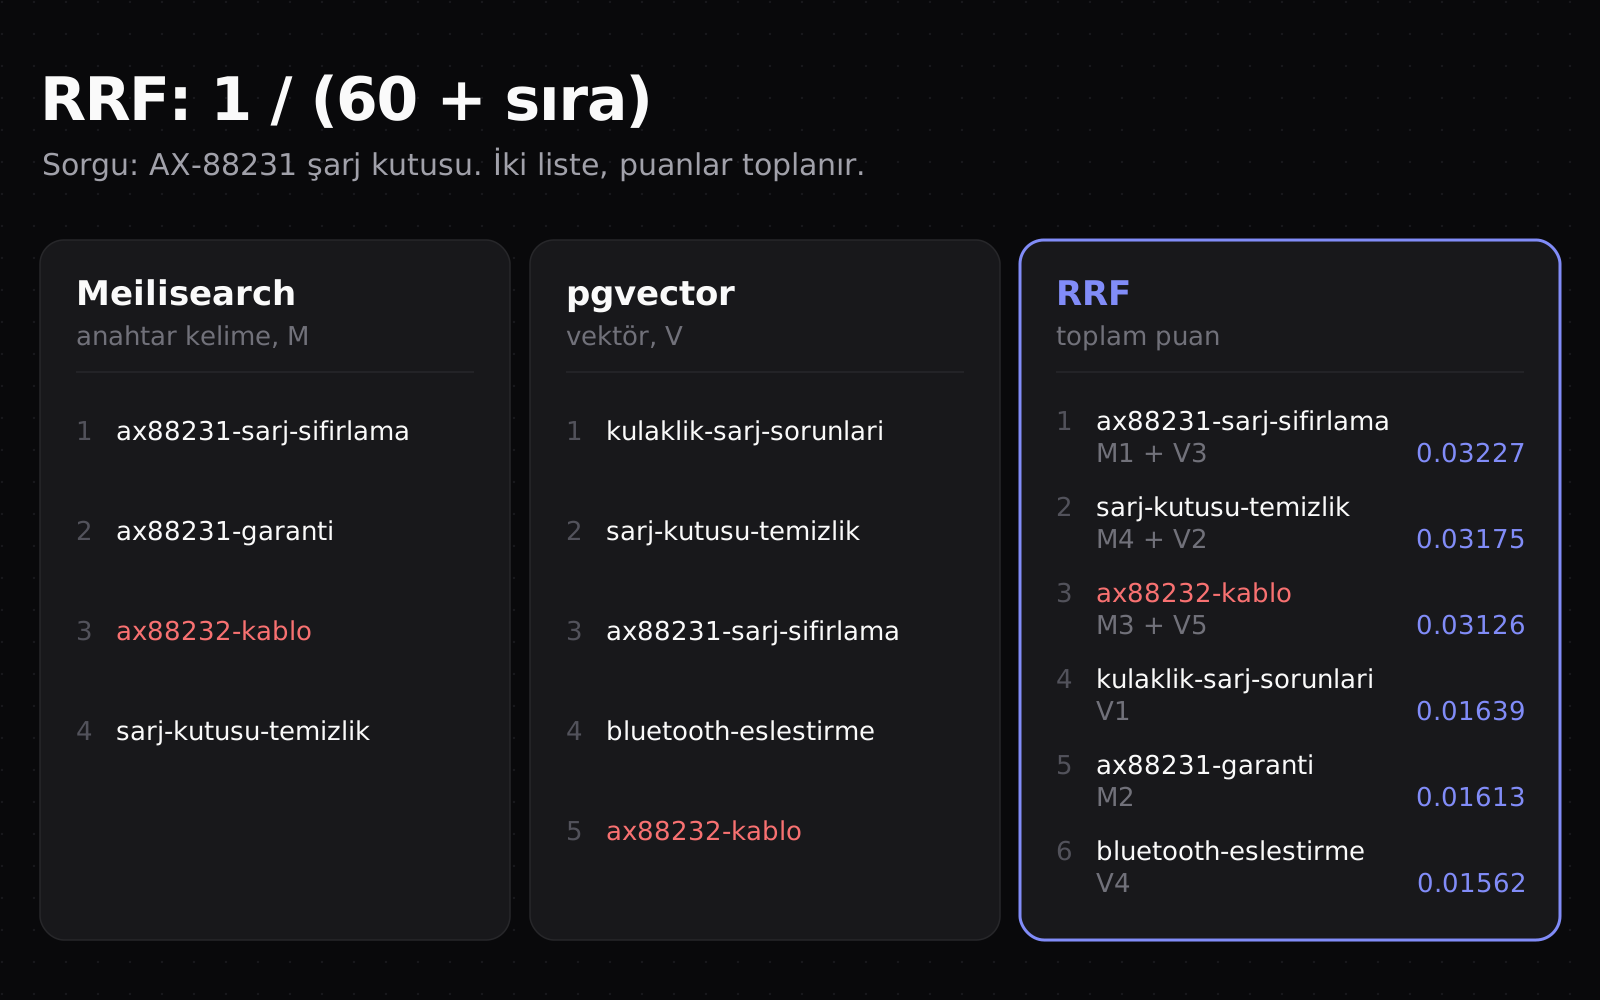
Çıktıda bir sorun var. Yanlış ürünün sayfası ax88232-kablo üçüncü sıraya çıktı ve doğru ürünün garanti sayfasını geçti. RRF uzlaşmayı ödüllendiriyor, iki liste de bu belgeyi gürültü olarak içeriyor ve iki gürültünün toplamı sinyal gibi görünüyor. Çözüm birleştirmede değil girdide. Meilisearch tarafında disableOnNumbers açılıp matchingStrategy: "all" verildiğinde AX-88232 anahtar kelime listesinden düşüyor ve aynı hesap şunu veriyor:
from rrf import rrf, vektor # disableOnNumbers + matchingStrategy "all" sonrası Meilisearch listesimeili = ["ax88231-sarj-sifirlama", "ax88231-garanti", "sarj-kutusu-temizlik"] for belge, s in rrf([meili, vektor]): print(f"{s:.5f} {belge}") # 0.03227 ax88231-sarj-sifirlama# 0.03200 sarj-kutusu-temizlik# 0.01639 kulaklik-sarj-sorunlari# 0.01613 ax88231-garanti# 0.01562 bluetooth-eslestirme# 0.01538 ax88232-kabloAğırlıklı skor toplamı neden kırılgan
Aynı sorguyu bir de skorlarla birleştirelim. Vektör tarafında skor 1 − kosinüs mesafesi, Meilisearch tarafında _rankingScore. Listede olmayan belge sıfır alıyor.
# Aynı sorgu, bu kez motorların verdiği skorlarlameili = {"ax88231-sarj-sifirlama": 0.99, "ax88231-garanti": 0.86, "ax88232-kablo": 0.83, "sarj-kutusu-temizlik": 0.61} # _rankingScorevektor = {"kulaklik-sarj-sorunlari": 0.862, "sarj-kutusu-temizlik": 0.851, "ax88231-sarj-sifirlama": 0.847, "bluetooth-eslestirme": 0.811, "ax88232-kablo": 0.804} # 1 - cosine mesafesi def minmax(d): lo, hi = min(d.values()), max(d.values()) return {b: (s - lo) / (hi - lo) for b, s in d.items()} def agirlikli(a, b, alfa=0.5): belgeler = set(a) | set(b) s = {x: alfa * a.get(x, 0.0) + (1 - alfa) * b.get(x, 0.0) for x in belgeler} return sorted(s.items(), key=lambda x: (-x[1], x[0])) print("ham skorlar:")for belge, s in agirlikli(meili, vektor): print(f" {s:.3f} {belge}")print("min-max sonrası:")for belge, s in agirlikli(minmax(meili), minmax(vektor)): print(f" {s:.3f} {belge}") # ham skorlar:# 0.918 ax88231-sarj-sifirlama# 0.817 ax88232-kablo# 0.730 sarj-kutusu-temizlik# 0.431 kulaklik-sarj-sorunlari# 0.430 ax88231-garanti# 0.406 bluetooth-eslestirme# min-max sonrası:# 0.871 ax88231-sarj-sifirlama# 0.500 kulaklik-sarj-sorunlari# 0.405 sarj-kutusu-temizlik# 0.329 ax88231-garanti# 0.289 ax88232-kablo# 0.060 bluetooth-eslestirmeHam toplamda yanlış ürün ikinci sıraya çıkıyor. Min-max normalizasyonu ise vektör listesindeki 0,804 ile 0,862 arasındaki 0,058'lik farkı 0 ile 1 arasına geriyor. Pratikte anlamsız bir fark birden belirleyici oluyor, her listenin son elemanı da sıfır alıp listede hiç yokmuş gibi davranıyor. Üç yöntemin üçü de ilk sırada anlaşıyor ama ikinci sıra seçtiğiniz normalizasyona göre değişiyor. Skor tabanlı birleştirme (score fusion) etiketli veriyle kalibre edilirse iyi çalışabilir, ama her model değişikliğinde bu ayarı yeniden yapmanız gerekir. RRF'de bu karar hiç yok.
Ağırlık ve eşitlik
RRF'yi sorgu türüne göre ağırlıklandırmak kolay: terim w / (k + sıra) olur. Sorguda ürün kodu kalıbı varsa anahtar kelime listesine daha yüksek ağırlık vermek, regex ile yakalanabilecek basit bir kural. Eşitlikleri de unutmayın. Listelerden yalnızca birinde birinci olan iki belge aynı puanı alır, 1/61. Bunu kimliğin sözlük sırasıyla bozmak, aşağıdaki değerlendirmede göreceğiniz gibi doğru belgeyi üçüncü sıraya atabilir. Kod içeren sorguda eşitliği anahtar kelime listesi lehine bozmak daha savunulabilir bir kural.
pgvector: aday listesini eksiksiz almak
RRF yalnızca önüne konan listeleri birleştirir, listede olmayan belge sıfır puan alır. Bu yüzden pgvector tarafında ilk iş, istediğiniz derinlikte aday aldığınızdan emin olmak. Bu iş iki yerde aksıyor: indeksin kendi tavanında ve filtrede.
HNSW mi, IVFFlat mı
| HNSW | IVFFlat | |
|---|---|---|
| Yapı | Katmanlı yakınlık grafiği | Vektörleri kümelere (lists) bölüp sorguya yakın kümeleri tarar |
| İndeks oluşturma | Daha yavaş, daha çok bellek | Daha hızlı, daha az bellek |
| Hız ve recall dengesi | Daha iyi | Daha zayıf |
| Boş tabloda oluşturma | Olur, eğitim adımı yok | Önerilmez, kümeler mevcut veriden çıkarılır |
| Oluşturma parametresi | m (16), ef_construction (64) | lists: 1 milyon satıra kadar satır/1000, üstünde √satır |
| Sorgu parametresi | hnsw.ef_search (40) | ivfflat.probes (1, başlangıç için √lists) |
HNSW, Malkov ve Yashunin'in tarif ettiği katmanlı grafik. Arama seyrek üst katmandan girip her katmanda sorguya yaklaşarak yoğun alt katmana iniyor. m her düğümün katman başına en fazla kaç bağlantı tutacağını, ef_construction indeks kurulurken tutulan aday listesinin boyunu belirliyor. İkisini büyütmek recall'u artırır, karşılığında indeks daha yavaş kurulur, m büyüdükçe de şişer. Sorgu anındaki karşılığı hnsw.ef_search. 50 bin satırlık, 16 boyutlu rastgele vektörlerden oluşan bir tabloda 100 sorguyla, indekssiz kesin sonuca göre recall@10 şöyle çıktı:
| hnsw.ef_search | recall@10 |
|---|---|
| 10 | 0,884 |
| 20 | 0,968 |
| 40 (varsayılan) | 0,994 |
| 100 | 0,999 |
| 200 | 1,000 |
Bu sayılar yalnızca bu yapay veri için geçerli, gerçek embedding'lerde ölçümü kendi verinizle tekrarlayın. ef_search'ün bir başka etkisi ise her veride aynı: dönen satır sayısının da tavanı.
SELECT count(*) AS aday FROM ( SELECT id FROM belge ORDER BY emb <=> :q LIMIT 100) t;-- aday-- -------- 40 BEGIN;SET LOCAL hnsw.ef_search = 100;SELECT count(*) AS aday FROM ( SELECT id FROM belge ORDER BY emb <=> :q LIMIT 100) t;-- aday-- -------- 100COMMIT; -- İndeks vector_cosine_ops, sorgu iç çarpım operatörüyleEXPLAIN (COSTS OFF)SELECT id FROM belge ORDER BY emb <#> :q LIMIT 10;-- Limit-- -> Sort-- Sort Key: ((emb <#> '[0.3,-0.1,...]'::vector))-- -> Seq Scan on belgeBirleştirmeye 100 aday vermek istiyorsanız ef_search en az 100 olmalı. SET LOCAL ayarı yalnızca o transaction için değiştirir, bağlantı havuzundaki diğer sorgulara sızmaz.
Aynı bloğun son kısmı mesafe metriğiyle ilgili. pgvector'da <-> L2, <#> negatif iç çarpım, <=> kosinüs mesafesi. Embedding'leriniz birim uzunluğa normalize edilmişse kosinüs ile iç çarpım aynı sırayı verir ve README performans için iç çarpımı öneriyor. <#> negatif değer döndürür, çünkü PostgreSQL indeks taramasını yalnızca artan sırayla yapabiliyor. Benzerliği göstermek için -1 ile çarpmanız gerekir. Asıl tuzak operatör sınıfı: indeks vector_cosine_ops ile kurulduysa ve sorguda <#> kullanırsanız planlayıcı indeksi görmez, tabloyu baştan sona tarar.
Filtreli aramada eksilen sonuçlar
HNSW'de WHERE koşulu indeks tarandıktan sonra uygulanır. Koşul satırların yüzde 10'unu tutuyorsa varsayılan ayarlarla ilk 40 adaydan ortalama 4'ü kalır. Aynı tabloda denediğimde LIMIT 10 yazdığım sorgu 5 satır döndürdü, yüzde 1'lik filtrede hiç satır gelmedi:
CREATE EXTENSION IF NOT EXISTS vector;SELECT setseed(0.42);CREATE TABLE belge (id bigint PRIMARY KEY, kategori int NOT NULL, emb vector(16) NOT NULL);-- 50 000 satır, 16 boyutlu rastgele vektörler, kategori = id % 10INSERT INTO belgeSELECT i, i % 10, (SELECT array_agg(random() - 0.5) FROM generate_series(1, 16) WHERE i > 0)::vectorFROM generate_series(1, 50000) AS i;CREATE INDEX belge_emb_hnsw ON belge USING hnsw (emb vector_cosine_ops) WITH (m = 16, ef_construction = 64);ANALYZE belge; \set q '''[0.3,-0.1,0.2,0.4,-0.3,0.1,0.0,0.2,-0.2,0.3,0.1,-0.4,0.2,0.0,-0.1,0.3]''' EXPLAIN (COSTS OFF)SELECT id FROM belge WHERE kategori = 3 ORDER BY emb <=> :q LIMIT 10;-- Limit-- -> Index Scan using belge_emb_hnsw on belge-- Order By: (emb <=> '[0.3,-0.1,...]'::vector)-- Filter: (kategori = 3) SELECT count(*) FROM ( SELECT id FROM belge WHERE kategori = 3 ORDER BY emb <=> :q LIMIT 10) t;-- 5 (filtre yüzde 10, ef_search = 40) SELECT count(*) FROM ( SELECT id FROM belge WHERE id % 100 = 7 ORDER BY emb <=> :q LIMIT 10) t;-- 0 (filtre yüzde 1) SET hnsw.iterative_scan = strict_order;-- aynı iki sorgu: 10 ve 10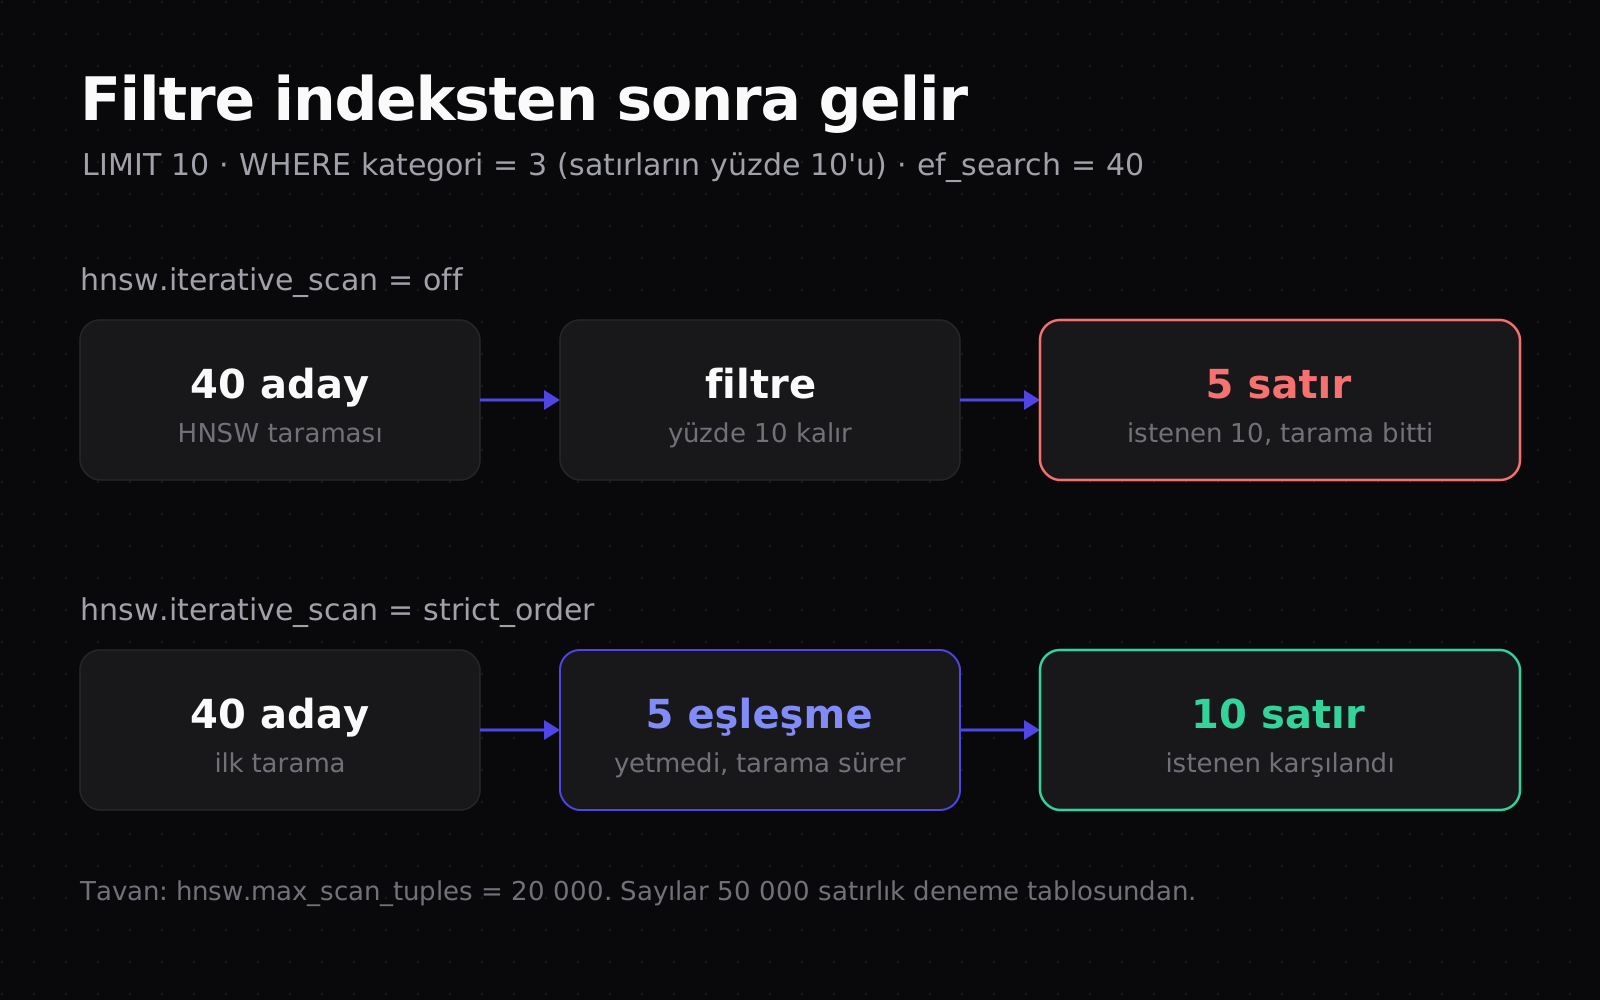
Ekim 2024'te çıkan pgvector 0.8.0'dan önce tek çare ef_search'ü tahminle büyütmekti. 0.8.0 ile gelen iterative index scan, yeterli sonuç bulunana kadar indeksi taramayı sürdürüyor. strict_order sonuçları mesafeye göre kesin sırada verir, relaxed_order sırayı biraz bozma pahasına daha iyi recall verir. Taramanın tavanı hnsw.max_scan_tuples (varsayılan 20 000). Filtre çok seçiciyse bu tavana takılıp yine eksik sonuç alabilirsiniz. Az sayıda farklı değerle filtreliyorsanız (tenant, dil, belge türü) kısmi indeks, çok sayıda değerde partitioning README'nin önerdiği yollar.
Denemeyi kendi makinenizde tekrarlamak için pgvector/pgvector:0.8.2-pg18 imajı yeterli. Konteynerlere yeniyseniz Docker temelleri yazısı başlangıç için işinizi görür. PostgreSQL temelleri için de SQL ve ilişkisel veri tabanı rehberi var.
Meilisearch'ün kendi hibrit araması
Meilisearch hibrit aramayı 1.6 sürümünde (Ocak 2024) deneysel olarak getirdi, yapay zekâ destekli arama 1.13 ile (Şubat 2025) kararlı hâle geldi. Sorguya hybrid: { embedder, semanticRatio } eklemek yetiyor, semanticRatio varsayılanı 0,5. Embedding'leri kendiniz üretiyorsanız userProvided kaynağıyla vektörleri her belgenin _vectors alanında gönderebilirsiniz.
Bu birleştirme RRF değil. 1.44'ün kaynağında (crates/milli/src/search/hybrid.rs) anahtar kelime skoru 1 − semanticRatio, semantik skor semanticRatio ile çarpılıp iki liste bu ağırlıklı skorlarla karşılaştırılıyor. Yani ağırlıklı bir skor birleştirmesi. Bir ayrıntı daha var: anahtar kelime araması sayfayı dolduracak kadar sonuç bulduysa ve her birinin skoru 1 − semanticRatio ile çarpıldığında 0,45'i geçiyorsa semantik arama hiç çalıştırılmıyor. Varsayılan oranla bu, bütün sonuçların 0,9'un üstünde olması demek.
# userProvided embedder, 4 boyutlu elle yazılmış vektörler, sorgu vektörü AX-88231'e yakıncurl -s -X POST 'http://localhost:7700/indexes/hibrit/search' \ -H 'Content-Type: application/json' \ --data-binary '{"q": "AX-88231", "vector": [0.95, 0.05, 0.0, 0.1], "limit": 1, "showRankingScore": true, "hybrid": {"embedder": "harici", "semanticRatio": 0.5}}'# limit 1: [(3, 0.999)] semanticHitCount = 0# limit 3: [(3, 0.999), (4, 0.996), (5, 0.659)] semanticHitCount = 2limit: 1 ile semantik arama atlandı. limit: 3 ile anahtar kelime listesi sayfayı dolduramadı, semantik arama devreye girdi ve AX-88232 vektörü sorguya çok yakın olduğu için 0,996 aldı. Semantik skor da ayrı bir ölçekte. Bu denemede skorlar (1 + kosinüs) / 2 ile birebir örtüştü, yani sorguyla hiç ilgisi olmayan dik bir vektör bile 0,5 alıyor. Yukarıdaki faturamı sorgusunun anahtar kelime skoru 0,235'ti.
Vektörler zaten Meilisearch'teyse yerleşik hibrit arama tek istekle iş görüyor. Embedding'ler pgvector'da duruyorsa aynı vektörleri Meilisearch'e de yazmak, iki deponun senkron kalmasını gerektirir. Ben bu durumda iki ayrı sorguyu uygulama katmanında RRF ile birleştirmeyi tercih ederim. Vektörler tek yerde kalır, birleştirme kuralı da sizin kontrolünüzde olur.
Ölçmeden ayar yapmayın
k'yi, ağırlıkları ya da semanticRatio'yu değiştirmeden önce bir test setine ihtiyacınız var. Büyük olması gerekmiyor. Gerçek sorgu kayıtlarından seçilmiş, sorgu türüne göre (kod, doğal dil, ekli kelime) etiketlenmiş birkaç düzine sorgu ve her biri için beklenen belgeler başlangıç için yeter.
recall@k, beklenen belgelerin ilk k sonuç içindeki oranı. RAG için bu ölçü daha anlamlı, çünkü modele giden bağlam ilk k belgeden ibaret. MRR (mean reciprocal rank) ise ilk doğru belgenin sırasının tersinin ortalaması ve kullanıcının ilk sonuca baktığı bir arama kutusu için daha uygun. Manning, Raghavan ve Schütze, ilk k sonuçtaki kesinliğin (precision@k) yaygın ölçüler arasında en az kararlı olanı olduğunu not ediyor. Küçük sette tek sorgu ortalamayı oynatır.
from rrf import rrf # Her sorgu: beklenen (ilgili) belgeler, Meilisearch listesi, vektör listesisorgular = { "AX-88231 şarj kutusu": ({"ax88231-sarj-sifirlama"}, ["ax88231-sarj-sifirlama", "ax88231-garanti", "sarj-kutusu-temizlik"], ["kulaklik-sarj-sorunlari", "sarj-kutusu-temizlik", "ax88231-sarj-sifirlama"]), "TR-2024-118 sipariş": ({"siparis-takip"}, ["siparis-takip", "siparis-iptal"], ["kargo-gecikme", "siparis-iptal", "iade-sureci"]), "faturamı iki kez ödedim": ({"cift-cekim", "iade-sureci"}, ["fatura-iptali", "e-fatura"], ["cift-cekim", "iade-sureci", "fatura-iptali"]), "paketim gelmedi": ({"kargo-gecikme"}, [], ["kargo-gecikme", "siparis-takip", "iade-sureci"]), "iade faturası": ({"fatura-iptali", "iade-sureci"}, ["fatura-iptali", "iade-sureci", "e-fatura"], ["iade-sureci", "cift-cekim", "fatura-iptali"]),} def recall_at(sonuc, ilgili, k): return len(set(sonuc[:k]) & ilgili) / len(ilgili) def rr(sonuc, ilgili): for sira, belge in enumerate(sonuc, start=1): if belge in ilgili: return 1 / sira return 0.0 yontemler = { "yalnız Meilisearch": lambda m, v: m, "yalnız vektör": lambda m, v: v, "RRF (k=60)": lambda m, v: [b for b, _ in rrf([m, v])],}print(f"{'yöntem':<20}{'recall@2':>10}{'MRR':>8}")for ad, f in yontemler.items(): r2 = [recall_at(f(m, v), ilgili, 2) for ilgili, m, v in sorgular.values()] mrr = [rr(f(m, v), ilgili) for ilgili, m, v in sorgular.values()] print(f"{ad:<20}{sum(r2)/len(r2):>10.3f}{sum(mrr)/len(mrr):>8.3f}") print()print(f"{'sorgu (RR)':<26}{'Meili':>8}{'vektör':>8}{'RRF':>8}")for q, (ilgili, m, v) in sorgular.items(): print(f"{q:<26}" + "".join(f"{rr(f(m, v), ilgili):>8.2f}" for f in yontemler.values())) # $ python3 degerlendir.py# yöntem recall@2 MRR# yalnız Meilisearch 0.600 0.600# yalnız vektör 0.500 0.667# RRF (k=60) 0.700 0.767## sorgu (RR) Meili vektör RRF# AX-88231 şarj kutusu 1.00 0.33 1.00# TR-2024-118 sipariş 1.00 0.00 0.33# faturamı iki kez ödedim 0.00 1.00 0.50# paketim gelmedi 0.00 1.00 1.00# iade faturası 1.00 1.00 1.00Ortalamada RRF önde, MRR 0,767. Sorgu başına tabloda ise başka bir şey görünüyor: TR-2024-118 sipariş sorgusunda Meilisearch'ün 1,00'lık sonucu RRF'de 0,33'e düşüyor. siparis-iptal iki listede de ikinci olduğu için öne geçti, doğru belge ise kargo-gecikme ile 1/61'de berabere kalıp sözlük sırasında geriye düştü. Ortalama bunu saklıyor. Bu sayılar benim kurduğum beş sorguluk oyuncak bir setten geliyor, RRF'nin üstünlüğünü kanıtlamıyor. Gösterdikleri, ölçüm düzeneği ve sorgu başına bakmanın gereği.
Sonuç
Kural şu: birleştirmeden önce her listeyi ayrı ayrı düzeltin ve derinliğini garanti edin, sonra sıralarla birleştirin. Ürün kodunu esneten yazım hatası toleransını, 40'ta kesilen aday listesini, filtre yüzünden beşe inen sonucu RRF düzeltemez, çünkü yalnızca önüne konanı görür. Birleştirmenin kendisi on satırlık bir fonksiyon. Emeği hak eden kısım, o fonksiyona giren listeler ve onları ölçen sorgu seti.
Sıkça Sorulan Sorular
- RRF'den sonra bir reranker gerekir mi?
- Gerekmez ama işe yarar. pgvector README'si hibrit arama için RRF'nin yanında cross-encoder'ı da anıyor. Cross-encoder sorguyla belgeyi birlikte okuyup puanladığı için RRF'den daha isabetli sıralar, karşılığında her aday için bir model çağrısı ister. Makul düzen, RRF'nin ilk 20 ile 50 arasındaki adayını bir reranker'a yeniden sıralatmak.
- Birleştirilmiş sonuçlarda sayfalama nasıl yapılır?
- Birleştirilmiş listenin ikinci sayfası, kaynak listelerin daha derinine inmeyi gerektirir. 20 sonuçlu ikinci sayfa için iki motordan da en az 40 aday almalısınız, yoksa sayfalar arasında belge kaybolur ya da tekrar eder. Daha temiz yol, ilk istekte iki motordan geniş bir aday kümesi (örneğin 100) alıp birleştirilmiş listeyi kısa süreli önbelleğe koymak ve sayfaları oradan vermek. pgvector tarafında 100 aday için
hnsw.ef_searchdeğerini de 100'e çıkarın. - Meilisearch yerine PostgreSQL'in tam metin araması kullanılamaz mı?
- Kullanılabilir ve hibrit aramayı tek SQL sorgusuna indirir. PostgreSQL'de Snowball stemmer'ını kullanan hazır bir
turkishmetin arama yapılandırması var. Ama kökler tutarlı değil: PostgreSQL 18'deto_tsvector('turkish', ...)faturavefaturamıiçinfatura,faturasıiçinfaturas,faturalarınızıiçinfaturüretiyor. Yazım hatası toleransı da yok, onun içinpg_trgmeklemeniz gerekir. - Embedding boyutu pgvector indeksine sığmazsa ne olur?
vectortipiyle HNSW ve IVFFlat indeksleri en fazla 2 000 boyut kabul ediyor. Daha büyük vektörlerihalfvec(yarım hassasiyet) ile 4 000 boyuta kadar indeksleyebilirsiniz, indeks de küçülür. Daha ötesi için binary quantization ya da model destekliyorsa vektörün bir alt bölümünü indeksleme var.
Kaynakça
- Cormack, G. V., Clarke, C. L. A., ve Büttcher, S. (2009). Reciprocal rank fusion outperforms Condorcet and individual rank learning methods. Proceedings of the 32nd International ACM SIGIR Conference on Research and Development in Information Retrieval içinde (ss. 758–759). ACM. https://doi.org/10.1145/1571941.1572114
- Malkov, Y. A., ve Yashunin, D. A. (2020). Efficient and robust approximate nearest neighbor search using hierarchical navigable small world graphs. IEEE Transactions on Pattern Analysis and Machine Intelligence, 42(4), 824–836. https://doi.org/10.1109/TPAMI.2018.2889473
- Manning, C. D., Raghavan, P., ve Schütze, H. (2008). Introduction to information retrieval. Cambridge University Press. https://doi.org/10.1017/CBO9780511809071
- Meilisearch. (t.y.-a). Custom hybrid ranking. Meilisearch Documentation. https://www.meilisearch.com/docs/capabilities/hybrid_search/advanced/custom_hybrid_ranking
- Meilisearch. (t.y.-b). Typo tolerance. Meilisearch Documentation. https://www.meilisearch.com/docs/capabilities/full_text_search/relevancy/typo_tolerance_settings
- pgvector. (t.y.). pgvector: Open-source vector similarity search for Postgres (README, sürüm 0.8.2). GitHub. https://github.com/pgvector/pgvector/blob/v0.8.2/README.md
Mustafa Kürşad Başer
Kıdemli Yazılım Mühendisi
Karmaşık sorunlara zarif çözümler üretmekten keyif alan, tutkulu bir yazılım mühendisi. Kodlamanın ötesinde, teknoloji, sanat ve insan bilincinin kesişim noktalarını keşfetmekle derinden ilgileniyor.