KYC Belgelerinde OCR: Textract, Vision Modeli ve Alan Bazında İnsan Onayı
 Mustafa Kürşad BAŞER
Okumak kolay, neyin okunduğunu bilmek zor
Özet (TL;DR)
- Textract her kelime için 0–100 arası bir güven ve konum verir, ama Türkçeyi desteklemez ve AnalyzeID yalnızca ABD kimlik belgelerini tanır.
- Vision modeli Türkçe harfleri ve serbest düzeni iyi okur, ama okuyamadığı alanı akıcı bir tahminle doldurabilir ve güven sayısı ölçülmüş bir olasılık değildir.
- Sağlam desen iş bölümüdür: OCR metni ve konumu çıkarır, model alanı seçip dayandığı satırı söyler, kod bu iddiayı satırla, kurallar da değeri sınar.
- MRZ'nin 7-3-1 ağırlıklı kontrol hanesi tek rakam hatalarının hepsini yakalar, 6 ile G'nin karışmasını ise hiç yakalamaz. G'nin sayısal değeri 16'dır.
- Kimlik fotoğrafını saklamak tek başına biyometrik veri işlemek sayılmaz. Fotoğrafı yüz eşleştirmesine soktuğunuz anda özel nitelikli veri işliyorsunuz.
Kimlik kartının ön yüzü modelden tertemiz bir JSON olarak dönüyor. Ad, soyad, doğum tarihi, seri numarası, hepsi dolu. Modelin kendi verdiği güven de yüksek. Oysa kartta doğum yılı 1997 yazıyor, JSON'da 1991 var. Seri numarasının köşesi flaş yansımasından okunmuyor, JSON'da ise eksiksiz bir seri numarası var. Ne bir hata fırladı ne bir şema ihlali oldu.
Sahne varsayımsal. Türkiye'deki bir ödeme altyapısı şirketi için geliştirdiğim üye işyeri başvuru platformunda iki yol yan yana çalışıyor: T.C. kimlik kartları OpenAI'ın Vision API'sine, vergi levhası ve ticaret sicili belgeleri AWS Textract'a gidiyor, ikisini belge türüne göre seçen tek bir OCR sağlayıcı katmanı var. Zor olan okumak değil, hangi alanın okunduğunu, hangisinin tahmin edildiğini ayırt etmek.
Textract neyi verir, neyi vermez
Textract'ın çıktısı Block nesnelerinden oluşur. Her WORD ve LINE bloğunun bir Confidence değeri ve Geometry içinde bir bounding box'ı vardır. AnalyzeDocument çağrısında FeatureTypes ile analizi seçersiniz: TABLES, FORMS, QUERIES, SIGNATURES ve LAYOUT. Vergi levhası gibi anahtar-değer düzenindeki bir belgede FORMS anahtarla değeri eşleşmiş verir. Her karakterin yerini ve servisin ondan ne kadar emin olduğunu bilirsiniz.
AnalyzeID ise dar bir alanda çalışıyor. Dokümantasyon onu ABD hükûmetinin verdiği pasaport ve sürücü belgeleri için tanımlıyor. Alanları FIRST_NAME, DATE_OF_BIRTH, DOCUMENT_NUMBER gibi standart adlarla ve alan başına güvenle döndürüyor, ABD pasaportunda MRZ'yi MRZ_CODE olarak ayrıca veriyor. T.C. kimlik kartı için elinizdeki araç AnalyzeDocument ya da DetectDocumentText ve onların ham satırları.
Dil desteği daha belirleyici. SSS sayfasına göre Textract basılı metin, form ve tablo çıkarımını İngilizce, Almanca, Fransızca, İspanyolca, İtalyanca ve Portekizce için sunuyor, metin algılama standart İngiliz alfabesi ve ASCII sembolleriyle sınırlı, Queries yalnızca İngilizce. Ç, Ğ, İ, ı, Ö, Ş ve Ü bu alfabenin dışında, GÜNEŞ'in GUNES gibi gelmesine hazırlıklı olun. Bunu kodlama bozulmasıyla karıştırmayın. Orada baytlar doğrudur, yorum yanlıştır. Burada harf baştan tanınmıyor. VKN, IBAN ve tarih gibi rakamlı alanlarda sorun yok, ticaret unvanında ve adreste var.
Vision modelinin iki yüzü
Görüntüyü okuyabilen dil modeli, yani vision modeli, bu açığı kapatıyor. Türkçe harfleri okuyor, etiketin hangi alana denk geldiğini anlıyor, eğik bir fotoğrafla ya da ticaret sicili gazetesinin serbest sayfasıyla başa çıkıyor.
Tehlike, hata yapma biçiminde. OCR yanıldığında bunu saklamaz, düşük güven verir, anlamsız karakter üretir. Model ise sessizce yanılır. Okuyamadığı alanı makul bir değerle doldurabilir, nadir bir soyadını daha yaygın bir yazıma "düzeltebilir", arka yüzdeki bir tarihi ön yüzdeki alana taşıyabilir. Çıktı her durumda akıcıdır.
Modelden alan başına güven istediğinizde aldığınız şey modelin ürettiği bir metindir, belgeyle karşılaştırılarak ölçülmüş bir olasılık değil. OpenAI'ın Ağustos 2024'te getirdiği Structured Outputs gibi şemaya bağlı çıktı modları JSON'un biçimini garanti eder, içeriğini etmez. Platformdaki kimlik akışında model bir güven skoru ve netlik, okunabilirlik, bütünlük ve ışık için bir kalite dökümü döndürüyor. Ben bunları "fotoğrafı yeniden çekin" demek için kullanırım, alan onayı için değil.
| Textract | Vision modeli | |
|---|---|---|
| Türkçe harfler | Desteklenen alfabenin dışında | Okur |
| Konum | Her kelime için bounding box | Güvenilir biçimde yok |
| Güven | Kelime ve satır başına 0–100 | Modelin ürettiği bir sayı |
| Serbest düzen | FORMS ve LAYOUT ile sınırlı | Güçlü |
| Hata biçimi | Düşük skor, bozuk karakter | Akıcı ve yanlış değer |
İş bölümü: OCR okur, model yerleştirir, kural karar verir
İki aracın zayıf yanları birbirinin tersi. OCR bağımsız bir tanık gibi belgede ne yazdığını ve nerede yazdığını söylüyor, model bu ifadeyi şemaya yerleştiriyor, kararı ikisinin de etkileyemeyeceği kod veriyor.
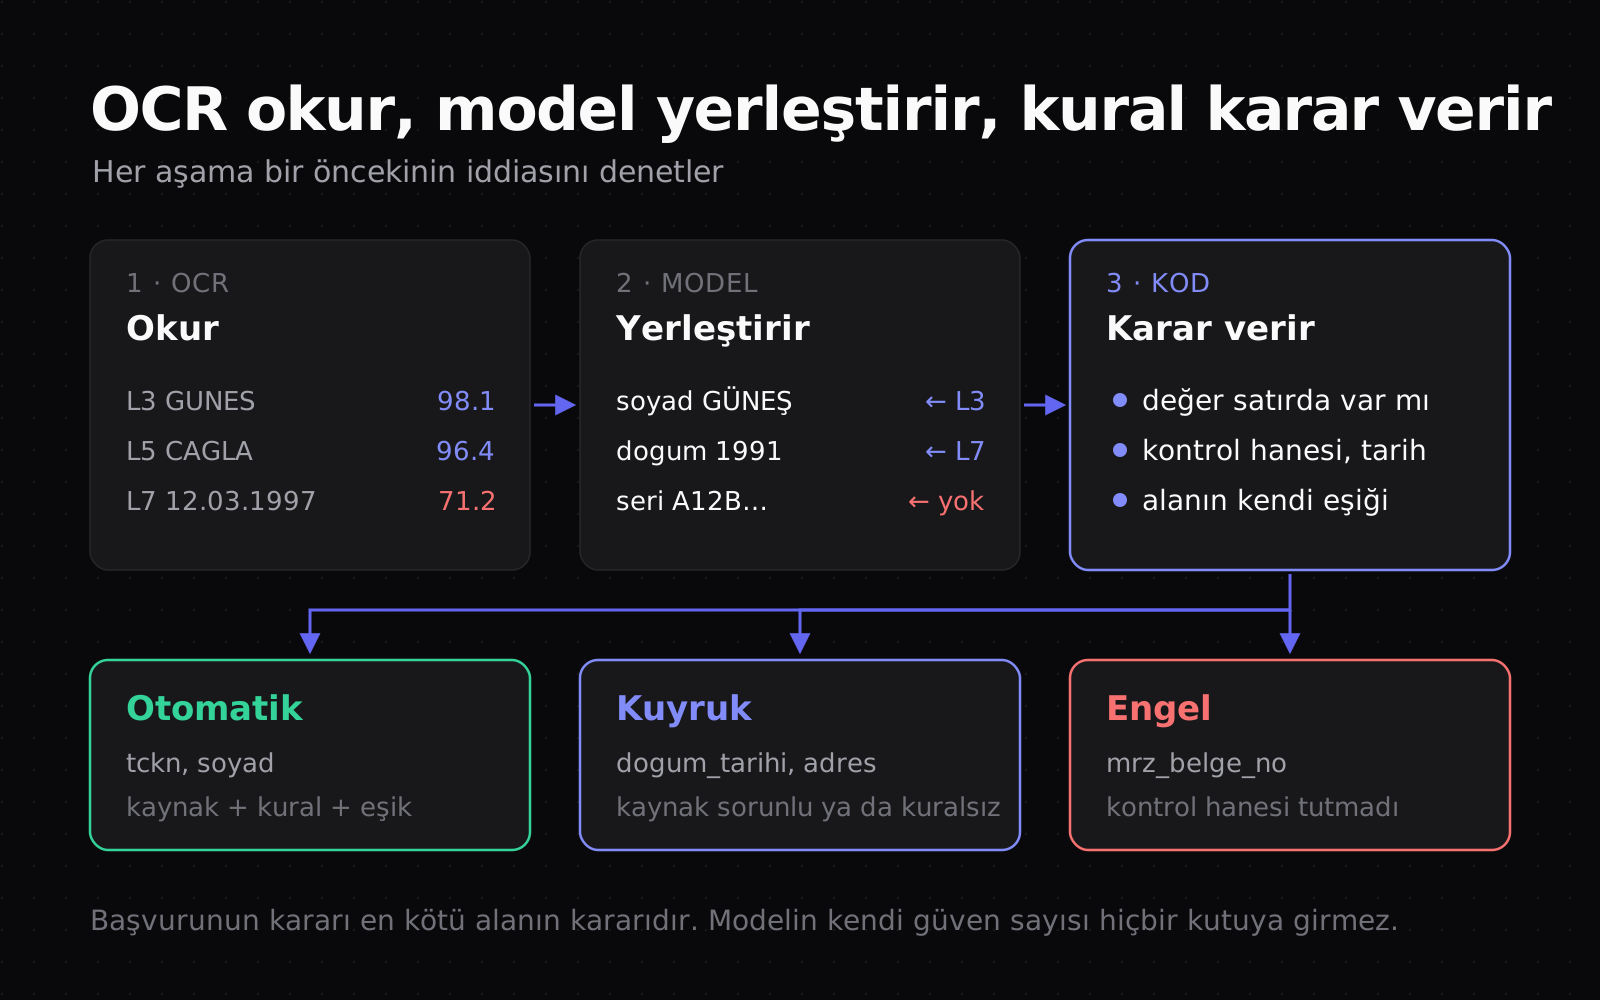
- 1OCR belgeyi satırlara ayırır. Her satıra bir ID (
L1,L2…), metin, en düşük kelime güveni ve konum yazılır. - 2Model numaralı satırları, gerekirse görüntüyü de alır. Her alan için bir değer ve dayandığı satırların ID'lerini döndürür, belgede olmayan alana
nullyazar. - 3Kod, değeri gösterilen satırlarla karşılaştırır. Satır yoksa ya da satırda başka bir şey yazıyorsa alan kaynaksızdır.
- 4Kontrol haneleri, tarih tutarlılığı ve belgeler arası eşleşme gibi deterministik kurallar çalışır.
- 5Her alan ayrı karar alır: otomatik, kuyruk ya da engel.
Model cevabını şu şemaya bağlamak yeterli. Satır ID'sini bir desenle sınırlamak, "üçüncü satırın sonu" gibi serbest bir referansı baştan engelliyor.
{ "type": "object", "additionalProperties": false, "required": ["soyad", "ad", "dogum_tarihi", "seri_no"], "properties": { "soyad": { "$ref": "#/$defs/alan" }, "ad": { "$ref": "#/$defs/alan" }, "dogum_tarihi": { "$ref": "#/$defs/alan" }, "seri_no": { "$ref": "#/$defs/alan" } }, "$defs": { "alan": { "type": "object", "additionalProperties": false, "required": ["deger", "kaynak"], "properties": { "deger": { "type": ["string", "null"] }, "kaynak": { "type": "array", "items": { "type": "string", "pattern": "^L[0-9]+$" } } } } }}Sağlayıcı şemaya uymayı garanti etse de cevabı sunucuda bir kez daha doğrulayın. TypeScript tarafında bunu Zod ile yapmak cevabı tipli bir nesneye de çeviriyor.
Model bir değer icat ettiyse ya gösterecek satırı yoktur ya da gösterdiği satırda başka bir şey yazar. Aşağıdaki OCR satırları ve model cevabı varsayımsal.
import unicodedata # OCR çıktısı: satır ID'si, metin, satırdaki en düşük kelime güveni (0-100)ocr_satirlari = { "L3": {"metin": "GUNES", "guven": 98.1}, "L5": {"metin": "CAGLA", "guven": 96.4}, "L7": {"metin": "12.03.1997", "guven": 71.2},} # Modelin şemaya uygun cevabı: her alan bir değer ve dayandığı satırlarmodel_cevabi = { "soyad": {"deger": "GÜNEŞ", "kaynak": ["L3"]}, "ad": {"deger": "ÇAĞLA", "kaynak": ["L5"]}, "dogum_tarihi": {"deger": "12.03.1991", "kaynak": ["L7"]}, "seri_no": {"deger": "A12B34567", "kaynak": []},} TR_ASCII = str.maketrans("ÇĞİÖŞÜçğıöşü", "CGIOSUcgiosu") def katla(s): s = unicodedata.normalize("NFC", s).translate(TR_ASCII).upper() return "".join(c for c in s if c.isalnum()) def kaynakla_esle(alan, cevap): satirlar = [ocr_satirlari.get(k) for k in cevap["kaynak"]] if not satirlar or None in satirlar: return alan, "KAYNAKSIZ", None birlesik = katla(" ".join(s["metin"] for s in satirlar)) if katla(cevap["deger"]) not in birlesik: return alan, "KAYNAKLA_CELISIYOR", None return alan, "ESLESTI", min(s["guven"] for s in satirlar) for alan, cevap in model_cevabi.items(): print(*kaynakla_esle(alan, cevap)) # Çıktı:# soyad ESLESTI 98.1# ad ESLESTI 96.4# dogum_tarihi KAYNAKLA_CELISIYOR None# seri_no KAYNAKSIZ NoneSoyadında model GÜNEŞ diyor, OCR GUNES okumuş. Türkçe harfler ASCII karşılıklarına çevrilince ikisi aynı. Ü ile Ş'yi model getiriyor, kanıtı OCR. Doğum tarihinde model 1991 yazmış ama gösterdiği satırda 1997 var, seri numarası için hiç satır göstermemiş. İkisi de eşiğe bakılmadan kuyruğa düşüyor.
Kısa değerlerde substring kontrolü zayıftır, tek harflik cinsiyet alanı her satırda geçer, orada tam kelime eşleşmesi isteyin. Ş mi S mi olduğuna da ne OCR ne ASCII olan MRZ tanıklık edebilir, Türkçe karakteri ancak formdaki adla sınarsınız. Platformdaki ad doğrulama katmanı OCR çıktısını form değerleriyle karşılaştırırken Türkçe karakterleri normalize ediyor, kısaltmaları ve birleşik soyadları tanıyor.
Modelin kandıramayacağı kurallar
Kaynak kontrolü değerin belgede olup olmadığını sorar. Kurallar değerin kendi içinde tutarlı olup olmadığını sorar ve modelin ne kadar ikna edici olduğundan bağımsız çalışır.
| Alan | Kontrol | Kör nokta |
|---|---|---|
| TC Kimlik No | İki kontrol hanesi | Rastgele 11 hanenin yaklaşık %1'i geçer |
| IBAN | ISO 7064 MOD 97-10 | Hesabın varlığını göstermez |
| MRZ alanları | 7-3-1 ağırlıklı mod 10 | Rastgele değerin yaklaşık %10'u geçer, 6 ile G ayırt edilemez |
| VKN | 10 hane ve kontrol hanesi | Resmî bir algoritma metni bulamadım |
| Tarihler | Doğum < veriliş < son geçerlilik, ön yüz = MRZ | Tutarlı ama yanlış tarih geçer |
| Ad soyad | Form, kimlik, MRZ ve vergi levhası karşılaştırması | Harf çevirisini bilmeyen karşılaştırıcı |
TCKN ve IBAN kontrol hanelerinin hesabını IBAN ve TC Kimlik No doğrulama yazısında anlattım. Burada önemli olan üçüncü sütun. Bir milyon rastgele 11 haneli sayıyla yaptığım denemede %0,99'u TCKN kontrolünden geçti. Model bir numara uydurduysa binlerce başvuruda bu sıfır değil. Doğrulayıcı gereklidir ama yeterli değildir. VKN için yaygın bir kontrol hanesi algoritması dolaşıyor ama Gelir İdaresinin yayımladığı resmî bir tarifini bulamadım. O yüzden VKN tutmadığında başvuruyu engellemek yerine kuyruğa almayı tercih ederim.
MRZ kontrol hanesi: 7, 3, 1
ICAO Doc 9303'ün 3. bölümüne göre alanın karakterleri soldan sağa 7, 3, 1… ağırlıklarıyla çarpılıp toplanır, toplamın 10'a bölümünden kalan kontrol hanesidir. Dolgu karakteri < sıfır, A ile Z arası harfler 10 ile 35 arası değer alır. Pasaportların kullandığı TD3 biçiminde 44 karakterlik ikinci satırda beş kontrol hanesi var: belge numarası (1–9, hanesi 10.), doğum tarihi (14–19, hanesi 20.), son geçerlilik (22–27, hanesi 28.), kişisel numara (29–42, hanesi 43.) ve 1–10, 14–20 ile 22–43 konumlarını kapsayan bileşik hane (44.). Örnek, 4. bölümdeki Utopia pasaportu.
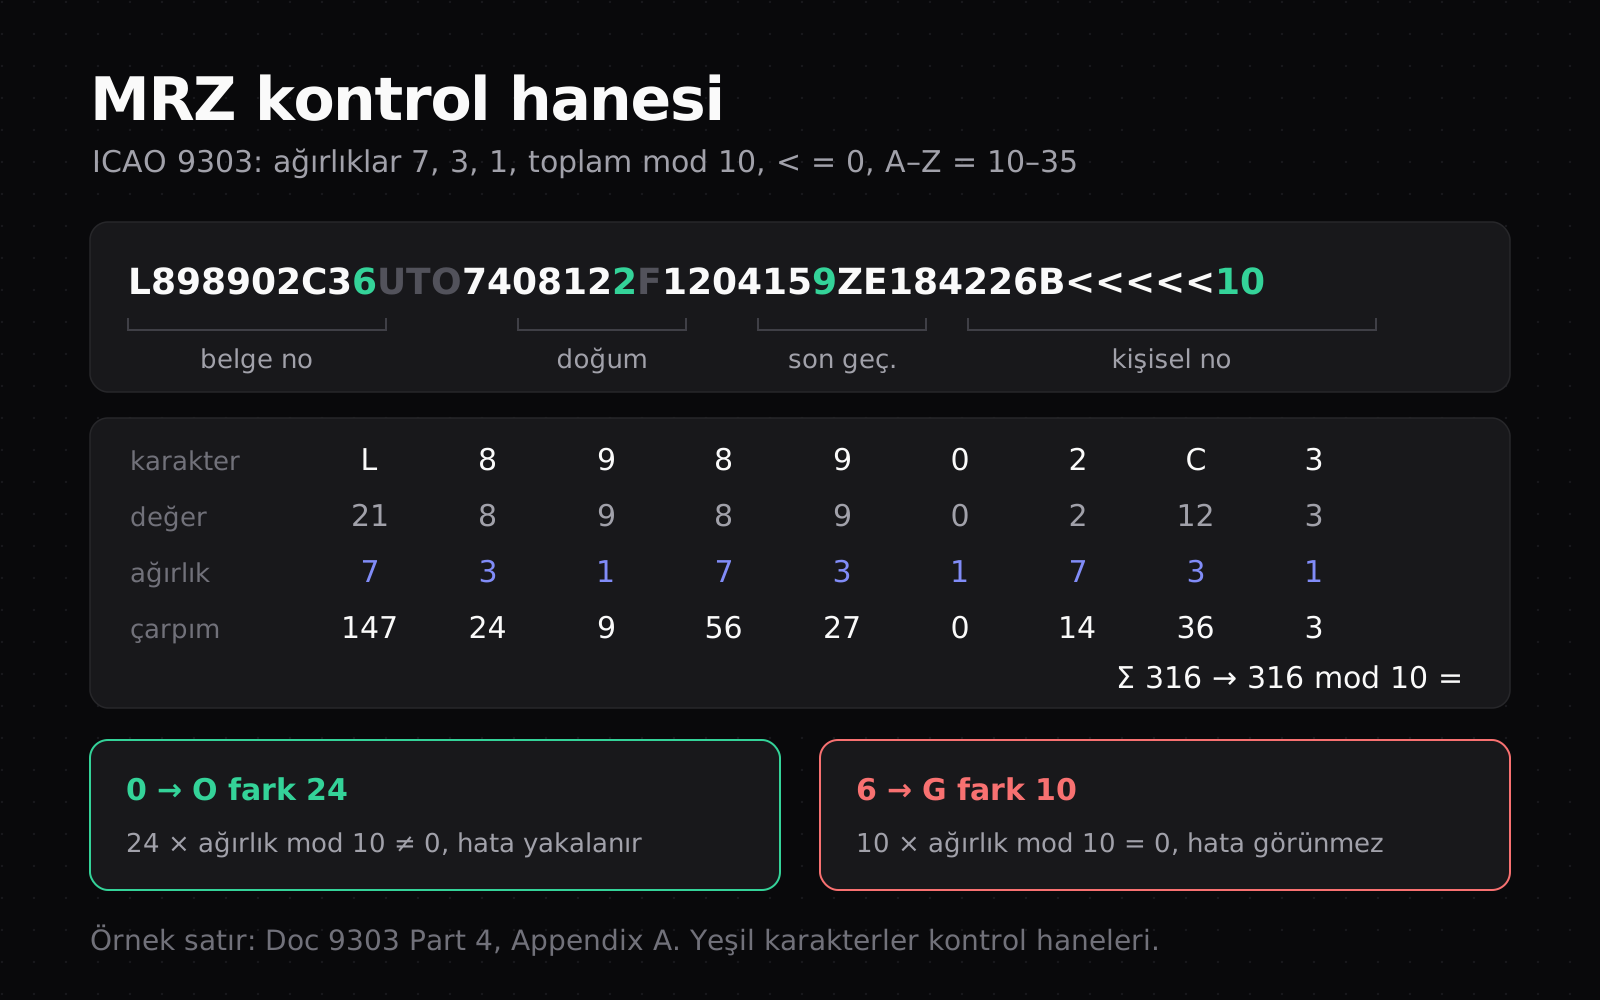
RAKAM = "0123456789" def deger(c): if c in RAKAM: return int(c) if "A" <= c <= "Z": return ord(c) - ord("A") + 10 if c == "<": return 0 raise ValueError(f"MRZ'de olmayan karakter: {c!r}") def kontrol_hanesi(alan): agirlik = (7, 3, 1) return sum(deger(c) * agirlik[i % 3] for i, c in enumerate(alan)) % 10 def td3_alt_satir(s): """ICAO 9303 Part 4: TD3 (pasaport) MRZ'sinin 44 karakterlik ikinci satırı.""" if len(s) != 44: raise ValueError(f"TD3 satırı 44 karakter olmalı, {len(s)} geldi") kontroller = { "belge_no": (s[0:9], s[9]), "dogum_tarihi": (s[13:19], s[19]), "son_gecerlik": (s[21:27], s[27]), "kisisel_no": (s[28:42], s[42]), "bilesik": (s[0:10] + s[13:20] + s[21:43], s[43]), } return {ad: kontrol_hanesi(veri) == deger(hane) for ad, (veri, hane) in kontroller.items()} ornek = "L898902C36UTO7408122F1204159ZE184226B<<<<<10" # Doc 9303 Part 4, Appendix Aprint(td3_alt_satir(ornek)) bozuk = ornek[:5] + "O" + ornek[6:] # OCR, belge numarasındaki 0'ı O harfi okuduprint(bozuk[:10])print(td3_alt_satir(bozuk)) sinsi = ornek.replace("ZE184226B", "ZE18422GB") # 6 yerine G okunduprint(sinsi[28:37])print(td3_alt_satir(sinsi)) # Çıktı:# {'belge_no': True, 'dogum_tarihi': True, 'son_gecerlik': True, 'kisisel_no': True, 'bilesik': True}# L8989O2C36# {'belge_no': False, 'dogum_tarihi': True, 'son_gecerlik': True, 'kisisel_no': True, 'bilesik': False}# ZE18422GB# {'belge_no': True, 'dogum_tarihi': True, 'son_gecerlik': True, 'kisisel_no': True, 'bilesik': True}Belge numarasındaki 0'ın O okunması hem alanın hanesine hem bileşik haneye takılıyor. Kişisel numaradaki 6'nın G okunması hiçbir kontrole takılmıyor. G'nin değeri 16, yani 6'dan tam 10 fazla. 10'un hangi ağırlıkla çarpımı olursa olsun mod 10'da sıfır kalıyor. Aynı kör nokta 8 ile I, 1 ile B ve 0 ile K arasında da var. Tek rakamın başka bir rakamla karıştığı hatalarda ise 7, 3 ve 1 on ile aralarında asal olduğu için 243.000 denemenin hiçbiri kaçmadı. Yan yana iki rakamın yer değiştirmesinde farkı 5 olan çiftler kaçıyor, denemede %11.
Pratik kural şu: alanın karakter kümesini bilin. Tarihler yalnızca rakamdır, orada görülen O'yu 0'a çevirmek güvenlidir. Harfle rakamın karıştığı belge ve kişisel numarada bunu otomatik yapmayın. Yıl iki hanelidir (YYMMDD), yüzyılı doğum tarihinde geçmişe, son geçerlilikte geleceğe göre seçin. Kimlik kartı boyutundaki TD1 belgeler üç satır kullanır, konumları 5. bölümde tanımlıdır. T.C. kimlik kartının arka yüzünü TD3 konumlarıyla okumayın. Ad karşılaştırmasında 3. bölümün harf çevirisi tablosu geçerli: Ç, Ğ, İ, ı ve Ş tek harfe iner, Ö "OE ya da O", Ü "UE, UXX ya da U" yazılabilir. Karşılaştırıcınız hepsini kabul etmeli.
Eşik belgeye değil alana konur
Belge düzeyinde tek bir güven skoru yanıltır. Ortalaması 98 olan bir kartta TCKN'nin tek hanesi 60'la okunmuş olabilir. O hane yanlışsa ortalama bir şey ifade etmez.
Chow 1970'te örüntü tanımada reddetme seçeneğini inceledi: en olası sınıfın olasılığı eşiğin altındaysa sınıflandırıcı karar vermez, örneği reddeder. Eşik yükseldikçe hata düşer, ret artar, doğru eşiği ikisinin göreli maliyeti belirler. KYC'de reddetmek insan kuyruğu demek. Yanlış onaylanmış bir TCKN ile yanlış onaylanmış bir adres satırı aynı bedeli ödetmediği için eşik de alan başına ayrıdır.
Chow'un hesabı güven sayısının gerçek bir olasılık olduğunu varsayıyor. Modelin ürettiği sayıyı bu hesaba koyamamanızın nedeni bu. Textract'ın skoru olasılık diye tanımlansa da Türkçe desteklenen diller arasında değil, kalibrasyonun sizin belgelerinizde tuttuğunu ölçmeden kabul etmeyin. Her alan için etiketli bir veri seti toplayıp farklı eşiklerde hata ve kuyruk oranını çıkarın.
SIRA = {"OTOMATIK": 0, "KUYRUK": 1, "ENGEL": 2} def alan_karari(alan, kaynak, guven, dogrulayici, esik): """dogrulayici: True (geçti), False (kaldı), None (bu alan için kural yok)""" if dogrulayici is False: return "ENGEL", "doğrulayıcıdan kaldı" if kaynak != "ESLESTI": return "KUYRUK", kaynak.lower() if guven < esik: return "KUYRUK", f"OCR güveni {guven} < {esik}" if dogrulayici is None: return "KUYRUK", "kural yok, tek dayanak OCR güveni" return "OTOMATIK", "kaynak + kural + eşik" # Eşikler alan bazında, kendi etiketli verinizden gelir.# Buradaki 95, AWS'nin Textract SSS'sindeki örnek değer.ESIK = {"tckn": 95, "soyad": 95, "dogum_tarihi": 95, "mrz_belge_no": 95, "adres": 95} alanlar = [ ("tckn", "ESLESTI", 99.2, True), ("soyad", "ESLESTI", 98.1, True), # MRZ'deki soyadla tutuyor ("dogum_tarihi", "KAYNAKLA_CELISIYOR", None, None), ("mrz_belge_no", "ESLESTI", 99.0, False), # kontrol hanesi tutmadı ("adres", "ESLESTI", 97.5, None),] kararlar = {}for alan, kaynak, guven, dogr in alanlar: karar, neden = alan_karari(alan, kaynak, guven, dogr, ESIK[alan]) kararlar[alan] = karar print(f"{alan:<13} {karar:<9} {neden}") print("başvuru:", max(kararlar.values(), key=SIRA.get)) # Çıktı:# tckn OTOMATIK kaynak + kural + eşik# soyad OTOMATIK kaynak + kural + eşik# dogum_tarihi KUYRUK kaynakla_celisiyor# mrz_belge_no ENGEL doğrulayıcıdan kaldı# adres KUYRUK kural yok, tek dayanak OCR güveni# başvuru: ENGELKuralı olmayan alan, OCR güveni yüksek olsa da kuyruğa düşüyor, çünkü tek dayanağı kalibrasyonunu bilmediğiniz bir sayı. Adres gibi düşük riskli alanları otomatik geçirmek istiyorsanız bunu bir istisna listesiyle açıkça yapın. Başvurunun kararı en kötü alanın kararıdır. Platformdaki ad doğrulaması da üç kademeli: otomatik onay, manuel inceleme ve ancak operatörün açıkça kaldırabildiği engel.
Operatöre değerin yanında OCR kutusundan kesilmiş görüntü parçasını gösterin ve her kararını o alan için etiket olarak saklayın. Yönetilen bir seçenek isterseniz AnalyzeDocument çağrısının HumanLoopConfig parametresi Amazon Augmented AI üzerinden bir insan inceleme akışı başlatabiliyor.
KVKK: kimlik kartı, fotoğraf ve biyometrik veri
Kimlik kartındaki her alan kişisel veri. 6698 sayılı Kanunun 6. maddesi biyometrik ve genetik veriyi, din, sağlık ve ceza mahkûmiyeti gibi verilerle birlikte özel nitelikli sayıyor. Peki fotoğraf biyometrik veri mi?
Kişisel Verileri Koruma Kurulu 2020/915 sayılı kararında GDPR'nin 51. gerekçe paragrafına dayanarak fotoğrafın işlenmesinin doğrudan biyometrik veri sayılamayacağını söylüyor. Fotoğraf, kişiyi tek başına tanımlamaya ya da doğrulamaya izin veren belirli bir teknik yöntemle işlendiğinde biyometrik veri oluyor. Kurumun Mart 2025 tarihli biyometrik veri rehberi de aynı iki koşulu arıyor: ayırt edici özelliklerin işlemeyle ortaya çıkarılması ve kimliği tanımlamaya ya da doğrulamaya yaraması.
Yazılımcı için çizgi net. Kartın taranmış görüntüsünü saklamak kişisel veri işlemektir. Selfie ile kimlik fotoğrafını karşılaştıran, yüzden şablon ya da vektör çıkaran her adım biyometrik veri işlemektir. O noktada 6. maddenin 7499 sayılı Kanunla değişip 1 Haziran 2024'te yürürlüğe giren üçüncü fıkrasındaki şartlardan birine dayanmanız gerekir: açık rıza, kanunlarda açıkça öngörülme, bir hakkın tesisi için zorunluluk gibi. Rehberdeki ölçülülük ilkesi ise doğrudan tasarıma dokunuyor. Yüz eşleştirmesine gerçekten ihtiyacınız yoksa "ileride lazım olur" diye kurmayın. Görüntüyü alan çıkarmak için modele gönderirken fotoğraf bölgesini maskeleyin, hiçbir metin alanı oradan gelmiyor.
Uyarı
Saklama ve imha
Kanunun 7. maddesi, işlenme sebepleri ortadan kalkınca verinin silinmesini, yok edilmesini ya da anonimleştirilmesini istiyor. Silme yönetmeliğinin 11. maddesine göre saklama ve imha politikası olan veri sorumlusu bunu ilk periyodik imhada yapar ve periyodik imha aralığı hiçbir durumda altı ayı geçemez. Kurum suç gelirlerinin aklanmasının önlenmesi mevzuatında yükümlüyse 5549 sayılı Kanunun 8. maddesi kimlik tespitine ilişkin belgeleri son işlem tarihinden itibaren sekiz yıl saklamayı istiyor. İki kural çatışmıyor, süreyi yasal yükümlülük belirliyor, süre bitince imha başlıyor.
Belgenin tek kopyası yok. İmha politikanızda her biri için ayrı satır olmalı:
- Bucket'taki özgün görüntü ya da PDF ve istemcide üretilmiş sayfa görüntüleri
- OCR'ın ham JSON çıktısı, çünkü belgedeki her kelimeyi koordinatıyla taşır
- Modele giden istek ve gelen cevap, sağlayıcı tarafında tutuluyorsa onların kopyaları
- Operatör panelindeki küçük resimler, önbellekler ve dışa aktarılmış dosyalar
- Hata izleme aracına düşmüş request body'ler
Süre dolduğunda imha bu listenin tamamına uygulanmalı. Yalnızca bucket'taki özgün dosyayı silmek, aynı veriyi OCR çıktısında ve loglarda bırakır.
Belgeyi kısa ömürlü imzalı URL ile göstermek
Platformda belgeler, sözleşmeler ve üye işyeri formları Supabase Storage'daki private bucket'larda duruyor. Operatör bir belgeyi açmak istediğinde sunucu önce o başvuruyu görme yetkisini kontrol etmeli, sonra kısa ömürlü bir imzalı URL üretmeli. Supabase'de bu createSignedUrl(path, expiresIn), süre saniye cinsinden. S3'te presigned URL, Signature Version 4 ile SDK ya da CLI üzerinden en fazla yedi gün geçerli olabiliyor, konsolda bir dakika ile on iki saat arası.
AWS'nin kendi ifadesiyle presigned URL bir bearer token'dır, elinde tutan herkese erişim verir. URL'yi her görüntülemede yeniden üretin ve veritabanına yazmayın. Süreyi tek bir görüntüleme oturumuna yetecek kadar kısa tutun. URL'yi loglamayın, imza query string'de duruyor.
Loglarda maskeleme
En iyi maske kişisel veriyi hiç loglamamaktır. Platformdaki OCR loglayıcısı her çağrı için modeli, token sayılarını, maliyeti ve gecikmeyi yazıyor, yani yalnızca meta veri. Yine de bir exception mesajı ham değeri loga taşıyabilir, son savunma hattı olarak handler'a bir filtre koyun.
import logging, re DESENLER = [ (re.compile(r"\b[1-9][0-9]{10}\b"), "[TCKN]"), (re.compile(r"\bTR[0-9]{2}(?: ?[0-9A-Z]{4}){5} ?[0-9A-Z]{2}\b"), "[IBAN]"), (re.compile(r"[A-Z0-9<]{30,44}"), "[MRZ]"), (re.compile(r"([?&](?:token|X-Amz-Signature)=)[^&\s]+"), r"\1[GİZLİ]"),] class KisiselVeriMaskesi(logging.Filter): def filter(self, kayit): mesaj = kayit.getMessage() for desen, yerine in DESENLER: mesaj = desen.sub(yerine, mesaj) kayit.msg, kayit.args = mesaj, None return True log = logging.getLogger("ocr")el = logging.StreamHandler()el.addFilter(KisiselVeriMaskesi())log.addHandler(el)log.setLevel(logging.INFO) log.info("ocr bitti belge=%s tckn=%s", "kimlik_on", "12345678901")log.info("mrz satırı: %s", "L898902C36UTO7408122F1204159ZE184226B<<<<<10")log.info("iban: %s", "TR33 0006 1005 1978 6457 8413 26")log.info("önizleme: %s", "https://x.supabase.co/storage/v1/object/sign/belgeler/k.jpg?token=eyJhbGciOi") # Çıktı:# ocr bitti belge=kimlik_on tckn=[TCKN]# mrz satırı: [MRZ]# iban: [IBAN]# önizleme: https://x.supabase.co/storage/v1/object/sign/belgeler/k.jpg?token=[GİZLİ]Filtre handler'da, çünkü Python'da logger'a eklenen filtre alt logger'lardan yayılan kayıtları görmez. Örnekteki 11 haneli sayı geçerli bir TCKN değil, IBAN ise SWIFT kaydındaki örnek numara.
Sonuç
Bir alanı otomatik onaylamadan önce üç soruya evet diyebilmelisiniz. Değer belgede parmakla gösterilebilecek bir satıra dayanıyor mu? Modelin etkileyemeyeceği bir kuraldan geçti mi? O alan için kendi etiketli verinizle ölçtüğünüz eşiği aşıyor mu? Birine hayır diyorsanız o alanı bir insan görür. Modelin kendi güven sayısı bu soruların hiçbirinin cevabı değil.
KVKK tarafında çizgi tek. Fotoğrafı yalnızca saklıyorsanız kişisel veri, yüz eşleştirmesine soktuğunuz anda özel nitelikli veri işliyorsunuz. O çizgiyi geçecekseniz dayanağını yazarak geçin.
Sıkça Sorulan Sorular
- Modele yalnızca görüntüyü verip her alanın koordinatını istemek OCR'ın yerini tutmaz mı?
- Tutmaz. Modelin döndürdüğü koordinat da modelin ürettiği bir çıktı, onu karşılaştıracağınız bağımsız bir kaynak yok. OCR'ın değeri bağımsızlığında. Model OCR'ın kaçırdığı bir metni okuduysa o alan kaynaksız kalıp kuyruğa düşer, insanın bakması gereken yer de zaten orası.
- Kimlik kartının arka yüzünü de istemeye değer mi?
- Bence değer. Ön yüzde olmayan kontrol haneleri MRZ ile arka yüzde. Doğum tarihi, son geçerlilik ve belge numarasını ön yüzle karşılaştırmak, uydurulmuş bir alanı yakalamanın en ucuz yolu. Bedeli aynı kişisel verileri taşıyan bir görüntü daha, onu da imha politikanıza ekleyin.
- Başvuran silme talebinde bulunursa sekiz yıllık saklama yükümlülüğü ne olur?
- Kanunun 7. maddesinin ikinci fıkrası, silme ve imhaya ilişkin diğer kanunlardaki hükümleri saklı tutuyor. Yasal süre devam ediyorsa veri silinmez ve başvurana bu gerekçeyle cevap verilir. Teknik tarafta veriyi operasyon ekranlarından çekip yalnızca yetkili rollerin görebildiği bir arşiv durumuna alın, süre dolunca ilk periyodik imhada yok edin.
Kaynakça
- Amazon Web Services. (t.y.). Analyzing identity documents. Amazon Textract Developer Guide. https://docs.aws.amazon.com/textract/latest/dg/how-it-works-identity.html
- Chow, C. K. (1970). On optimum recognition error and reject tradeoff. IEEE Transactions on Information Theory, 16(1), 41–46. https://doi.org/10.1109/TIT.1970.1054406
- International Civil Aviation Organization. (2021a). Machine readable travel documents: Part 3. Specifications common to all MRTDs (Doc 9303, 8. bs.). https://web.archive.org/web/20250826063051/https://www2023.icao.int/publications/Documents/9303_p3_cons_en.pdf
- International Civil Aviation Organization. (2021b). Machine readable travel documents: Part 4. Specifications for machine readable passports (MRPs) and other TD3 size MRTDs (Doc 9303, 8. bs.). https://web.archive.org/web/20250705082504/https://www.icao.int/publications/Documents/9303_p4_cons_en.pdf
- Kişisel Verileri Koruma Kurumu. (2025). Biyometrik verilerin işlenmesinde dikkat edilmesi gereken hususlara ilişkin rehber (KVKK Yayınları No: 55). https://www.kvkk.gov.tr/SharedFolderServer/CMSFiles/bd06f5f4-e8cc-487e-abe1-d32dc18e2d7e.pdf
- Kişisel Verilerin Korunması Kanunu, 6698 sayılı Kanun. (2016, 7 Nisan). Resmî Gazete (Sayı: 29677). https://www.mevzuat.gov.tr/mevzuat?MevzuatNo=6698&MevzuatTur=1&MevzuatTertip=5
Mustafa Kürşad Başer
Kıdemli Yazılım Mühendisi
Karmaşık sorunlara zarif çözümler üretmekten keyif alan, tutkulu bir yazılım mühendisi. Kodlamanın ötesinde, teknoloji, sanat ve insan bilincinin kesişim noktalarını keşfetmekle derinden ilgileniyor.