Sesli Yapay Zekâ Ajanlarında Gecikme Bütçesi: Sessizlikten İlk Sese
 Mustafa Kürşad BAŞER
Ajanı yavaşlatan çoğu zaman model değil, bekleme
Özet (TL;DR)
- İnsanlar soru ile cevap arasında ortalama 200 milisaniye kadar bekliyor. Bir ses platformunun endpointing için varsayılan beklemesi tek başına bunun iki katı olabiliyor, yani bütçe daha model çalışmadan aşılıyor.
- Kullanıcının duyduğu gecikme, sunucu kaydında gördüğünüzden büyüktür. Ses ağı iki kez geçer: müşterinin sesi size gelirken ve ajanın sesi ona dönerken. Telefon tarafındaki jitter tamponu da buna eklenir.
- Aşamaları sırayla değil iç içe çalıştırın. STT, LLM ve TTS stream olarak birbirine bağlandığında ilk ses, son token beklenmeden çıkar.
- Tool call içeren turda LLM iki kez çalışır. O turu ayrı ölçün ve tool çalışırken ajanı konuşturun.
- Bütçeyi p50 ile değil p95 ile kurun. Aşama p95'lerinin toplamı, uçtan uca p95'ten büyüktür, ikisini karıştırmayın.
Müşteri "yarın öğleden sonra müsait misiniz?" diye soruyor ve susuyor. Hattın öbür ucundaki ajan bir buçuk saniye ses vermiyor. Müşteri hattın düştüğünü düşünüp "alo?" diyor, ajan da tam o anda cevaba başlıyor. İki ses üst üste biniyor, ajan sözünün kesildiğini sanıp duruyor, müşteri bir daha soruyor. Konuşma üç tur sonra hâlâ aynı sorunun üstünde.
Bu tabloda tek bir suçlu aramak yanıltıcı. Kullanıcının sustuğu an ile ajanın ilk sesi arasında altı ayrı kalem var ve her biri birkaç yüz milisaniye isteyebiliyor. HeyPilot'ta asistanlar VAPI üzerinden çalışıyor. Beyin, ses ve transkripsiyon sağlayıcıları takılıp çıkarılabiliyor: LLM tarafında OpenAI, Anthropic Claude, Google Gemini ve Groq, ses tarafında ElevenLabs, Play.ht, Azure, Cartesia ve Deepgram. Bu esneklik gecikmeyi tek bir sayı gibi düşünmeyi imkânsız kılıyor, çünkü her kombinasyonun bütçesi başka. O yüzden önce gecikme bütçesini (latency budget) kalemlerine ayıracağım, sonra her kalemi düşürmenin yolunu ve hepsini nasıl ölçeceğinizi göstereceğim.
Çıta: insan konuşmasında 200 milisaniye
Stivers ve arkadaşları 2009'da Japoncadan Danimarkacaya, beş kıtadan on dilde gündelik konuşma kayıtlarını inceledi. Soru ile cevap arasındaki boşluğun ortalaması bütün veri kümesinde +208 ms çıktı. En hızlı dil Japoncaydı (+7 ms), en yavaşı Danimarkaca (+469 ms). Her dilde dağılımın tepesi 0 ile +200 ms arasındaydı. Yani diller arasında fark var ama hepsi aynı şeyi yapıyor: üst üste konuşmaktan da uzun sessizlikten de kaçınıyor.
İkinci referans telekomdan geliyor. ITU-T G.114, ağzınızdan çıkan sesin karşı tarafın kulağına varma süresi için şunu söylüyor: tek yön gecikme 150 ms'nin altında kalırsa uygulamaların çoğunda etkileşim pratikte fark edilmez (metindeki ifadeyle "essentially transparent"). Genel ağ planlamasında ise 400 ms aşılmamalı. Bu iki sayıyı karıştırmamak gerekiyor. G.114 yalnızca iletimi ölçüyor, cevap düşünme süresi onun konusu değil. Sesli ajanda ise iletim bütçenin yalnızca bir parçası, üstelik iki kez ödeniyor.
Skantze'nin 2021 tarihli derlemesi de konuşma sistemlerinin iki tipik derdini adıyla koyuyor: sık sık söz kesmek ve uzun yanıt gecikmesi. İkisi aynı ayarın iki ucunda duruyor, birini düzeltirken öbürünü bozmak çok kolay.
Bütçenin altı kalemi
Aşağıdaki tablo kalemleri sırasıyla veriyor. Sayı verdiğim her yerin kaynağı var. Sağlayıcıya, modele ve bölgeye göre değişen kalemlerde ise sayı vermiyorum, onları kendi trafiğinizde ölçmeniz gerekiyor.
| Aşama | Ne harcıyor | Dayanaklı referans |
|---|---|---|
| 1. Ses yakalama ve ağ | Paketleme, yayılım, yönlendirme | RTP'de G.711 için varsayılan paket 20 ms. Fiberde 5 µs/km |
| 2. VAD ve endpointing | Sessizlik eşiği ya da turn detection modeli | VAPI'de varsayılan bekleme 0,4 sn |
| 3. STT final sonucu | Final transkriptin oturması | Sağlayıcıya göre değişir, ölçün |
| 4. LLM ilk token | Prompt'un işlenmesi, kuyruk, ağ | Model, prompt boyu ve bölgeye göre değişir |
| 5. TTS ilk ses parçası | İlk sesin sentezi | Ses ve sağlayıcıya göre değişir |
| 6. Telefon hattı | Transcoding, jitter tamponu | Tampon tepe değerinin yarısı kadar ekler (G.114) |
1. Ses yakalama ve ağ
Telefon sesi G.711 ile saniyede 8.000 örnek ve 64 kbit/s olarak taşınıyor. Codec'in kendisi neredeyse bedava, G.114'ün tablosunda PCM için IP ortamındaki işlem gecikmesi 0,25 ile 0,375 ms arasında. Maliyet paketlemede: RFC 3551 ses için varsayılan paket aralığını 20 ms koyuyor. 20 ms'lik ses birikmeden paket yola çıkamaz.
Yayılım için G.114'ün planlama değeri fiberde 5 µs/km. İstanbul ile Frankfurt arası kuş uçuşu yaklaşık 1.870 km, bu da tek yönde en az 9 ms eder. İstanbul ile Virginia arası yaklaşık 8.400 km ve en az 42 ms. Gerçek kablo güzergâhı her zaman daha uzundur, yani bunlar alt sınır. Mobil şebeke için aynı tablo 80 ile 110 ms veriyor, ama o tablo 2003'ün şebekeleri için yazıldı. Bugün sizin müşterinizin hattında bu değer başka olabilir.
2. VAD ve endpointing
Ses etkinliği algılama (VAD) yalnızca "şu an ses var mı" sorusunu cevaplar. Asıl karar endpointing'de, yani konuşmanın bitip bitmediğine hükmedilen adımda verilir: kullanıcı sustu mu, yoksa nefes mi alıyor? En basit yöntem sabit bir sessizlik eşiği. Eşik kısa olursa ajan söz keser, uzun olursa her tura aynı bekleme eklenir.
VAPI'nin konuşma ayarları sayfası bu kalemin ne kadar büyük olabileceğini açıkça gösteriyor. Asistanın kullanıcı sustuktan sonra konuşmaya başlamadan önce beklediği süre olan waitSeconds varsayılan olarak 0,4 saniye. Bu, insan ortalamasının iki katı ve daha hiçbir model çalışmadı. Teknik destek gibi düşünerek konuşulan aramalar için doküman 1 saniyenin üstünü öneriyor. Anlamsal tarafta LiveKit'in turn detection modeli var. Bekleme süresini "kullanıcı hâlâ konuşuyor" olasılığına bağlayan varsayılan fonksiyon 200 + 8000 * x, yani bekleme 200 ms ile 8,2 saniye arasında gidip geliyor. Transkripsiyona dayalı yöntemde de noktalama gelmezse 1,5 saniye beklenen bir örnek veriliyor.
Türkçe için bir uyarı: aynı doküman LiveKit'i İngilizce için, VAPI'nin kendi modunu İngilizce dışındaki diller için öneriyor. Türkçede yüklem cümlenin sonunda geliyor ve "yarın saat üçte... gelebilir miyim" gibi bir cümlenin ortasındaki duraksama, eşik tabanlı bir sistem için cümle sonundan farksız. Telefon numarasını ya da T.C. kimlik numarasını gruplar hâlinde okuyan müşteri de her grubun arasında duruyor. Bekleme süresini bu tür duraksamaları içeren kendi Türkçe kayıtlarınızla deneyerek seçin.
3, 4 ve 5. STT, LLM ve TTS
Bu üç kalemin ortak noktası, değerlerinin seçtiğiniz sağlayıcıya, modele, bölgeye ve o anki yüke bağlı olması. Benim burada vereceğim bir sayı sizin kombinasyonunuz için yanlış olur. Değişmeyen ilkeler şunlar:
- STT'nin interim (ara) sonuçları hızlı gelir ama değişebilir. Final sonuç endpointing kararından sonra oturur. LLM'i interim sonuçla erken ısıtıp final sonuçla doğrulamak, bu kalemi önceki kalemle üst üste bindirmenin yoludur.
- LLM'in ilk token süresi prompt'un uzunluğuyla büyür. Uzun bir system prompt, her tura eklenen bilgi bankası parçaları ve şişen konuşma geçmişi, modelin ilk kelimeyi söylemeden önce okuması gereken metni büyütür.
- TTS doğal bir tonlama için biraz metne ihtiyaç duyar. Tek kelimeyle sentez başlatmak tonlamayı bozar. Bütün paragrafı beklemek ise gecikmeyi bozar. Doğru birim ilk cümle ya da ilk yan cümledir.
6. Telefon hattı
SIP trunk üzerinden gelen çağrıda ses taşıyıcıdan geçer, gerekirse transcoding yapılır ve alıcı tarafta bir jitter tamponuna girer. Paketler ağda farklı sürelerde yol aldığı için tampon onları sıraya dizip sabit bir akışa çevirir. G.114 planlama için tamponun, tepe boyunun yarısı kadar gecikme eklediğini varsaymayı öneriyor ve verdiği örnekte 50 ms'lik değişkenliği karşılayacak bir tampon ortalamada 25 ms ekliyor. Bu kalemi siz yönetmiyorsunuz ama bütçeden düşmeniz gerekiyor.
Kalemleri üst üste değil, iç içe koymak
Altı kalem sırayla çalışırsa gecikme toplamlarına eşit olur. Stream olarak bağlandığında ise her aşama, öncekinin ilk çıktısıyla işe başlar. LLM token üretirken TTS ilk cümleyi seslendirir, ilk ses parçası hatta giderken model hâlâ ikinci cümleyi yazıyor olabilir. Ölçtüğünüz şey artık toplam değil, ilk sesin varış anı.
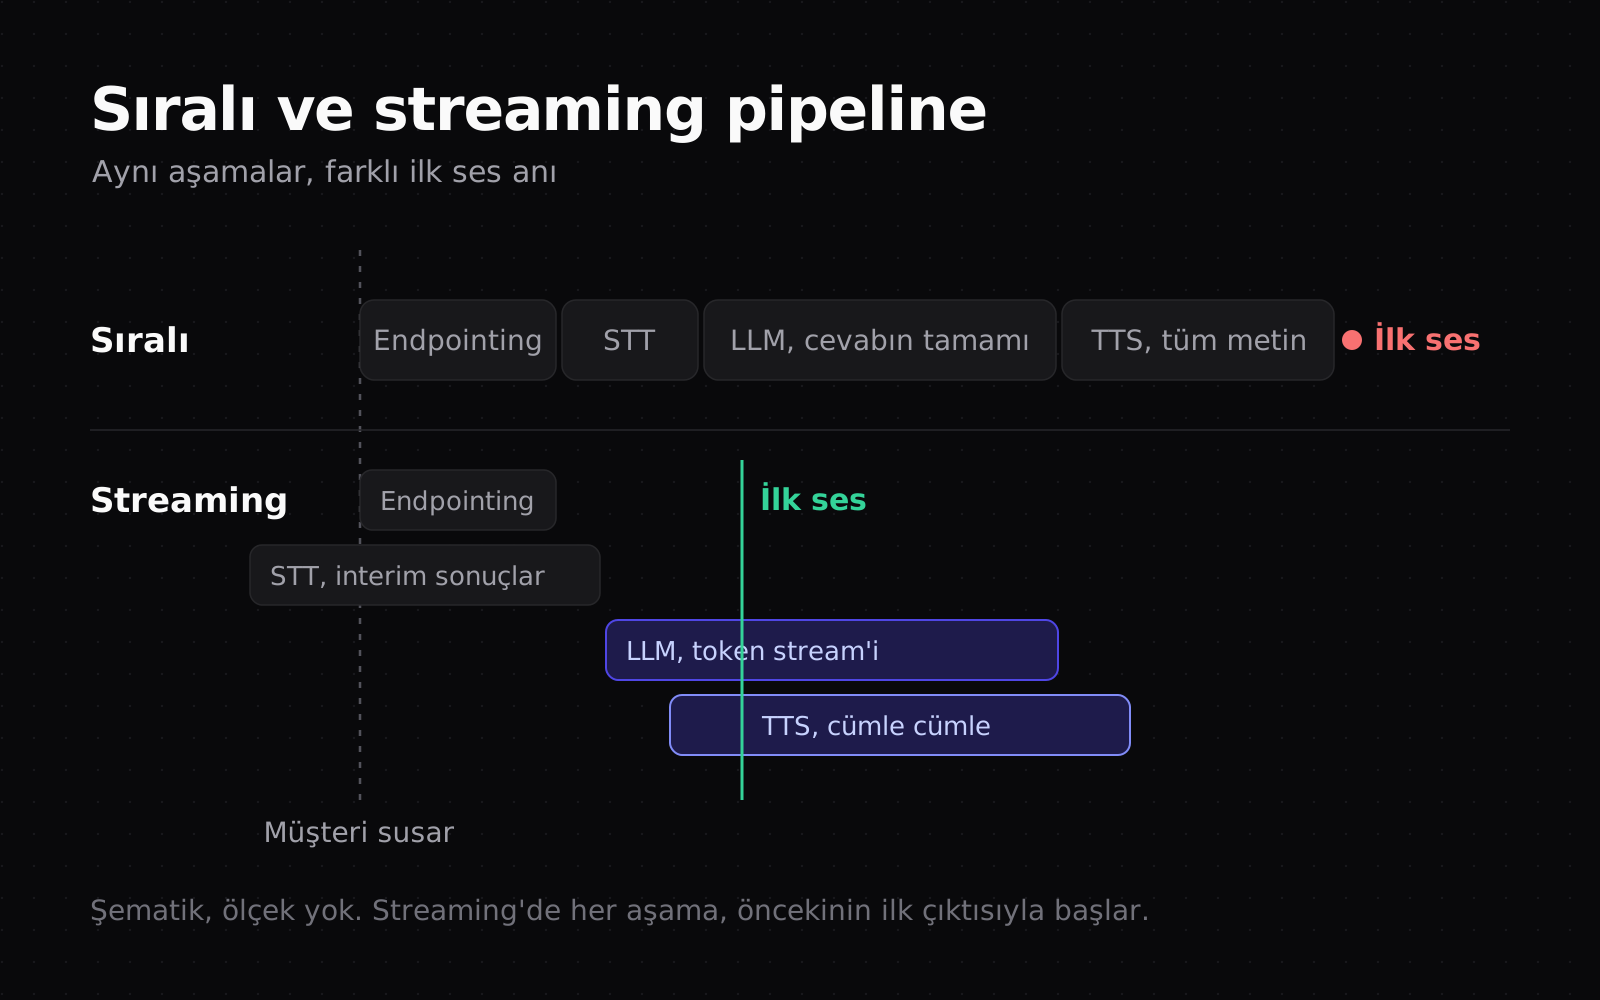
Node.js'te bu zinciri kuruyorsanız, aşamaları EventEmitter'larla ya da stream'lerle bağlamak doğal yoldur. EventEmitter yazısındaki desen burada da geçerli: her aşama "ilk parça hazır" olayını yayar, bir sonraki aşama onu bekler, son çıktıyı değil. Bunun dışında bütçeden kalıcı olarak düşebileceğiniz kalemler var:
- System prompt'a cevabı kısa bir onayla açmasını yazın ("Tabii, bakıyorum."). TTS'in ilk parçası ne kadar kısa metinden üretilirse o kadar erken çıkar.
- "Hmm" ya da "bir saniye" gibi kısa sesler, model düşünürken hattı canlı tutar. Önceden kaydedilmiş bir dolgu hiç TTS beklemez. Ama her turda çalarsa kısa sürede yapay duyulur.
- İlk mesaj çoğu asistanda sabittir. Bir kez sentezleyip saklarsanız çağrının ilk turunda TTS kalemi sıfıra iner. Selamlamada müşterinin adı gibi değişken bir parça varsa sabit kısmı önbellekten, değişken kısmı canlı üretin.
- Orkestrasyonu yapan sunucu İstanbul'daki müşteriyle Virginia'daki bir STT arasında gidip geliyorsa, her sıralı istek okyanusu iki kez geçer. Fiberin alt sınırıyla bile bu, gidiş dönüş en az 84 ms eder. Mümkünse sağlayıcıları ve orkestrasyonu aynı bölgeye, telefon taşıyıcısına yakın bir yere koyun.
Tool call sırasında sessiz kalmamak
HeyPilot'ta randevular görüşme sırasında VAPI tool call'larıyla alınıyor. Tool call içeren bir tur bütçeyi ikiye katlar: model önce tool'u çağırmaya karar verir, tool çalışır, sonra model sonucu okuyup asıl cevabı üretir. Yani o turda iki ayrı ilk token süresi ve arada bir HTTP isteği var. Bu sırada hat sessiz kalırsa müşteri yine "alo?" der.
VAPI'nin custom tools dokümanı tool çalışırken söylenecek mesajları tanımlamaya izin veriyor: istek başlarken, bittiğinde, hata verdiğinde ve geciktiğinde. "Takviminize bakıyorum" gibi bir başlangıç mesajı tool'un süresini doldurur. Tool'un kendisini de hızlı tutun. Argümanları Zod gibi bir şemayla baştan doğrulamak, modelin bozuk bir argümanla tool'u ikinci kez çağırmasını ve turun üçüncü bir LLM çağrısına uzamasını önler.
Barge-in: susmayı bilen ajan
Kullanıcı ajanın sözünü kestiğinde ajanın hemen susması gerekir. Bunun üç zor tarafı var. Birincisi, TTS'i durdurmak yetmez. Sesin bir kısmı zaten taşıyıcıya gönderilmiş ve tamponlarda bekliyor olabilir, onları da boşaltmanız gerekir. İkincisi, modelin konuşma geçmişine ajanın üretip söylemediği cümleler girmemeli. Yarıda kalan cevabı, gerçekten çalınan kısmına kadar kırpın. Yoksa model, müşterinin hiç duymadığı bir bilgiyi söylemiş gibi devam eder.
Üçüncüsü yanlış tetiklenme. Müşterinin "hı hı" ya da "evet" gibi dinlediğini gösteren kısa sesleri söz kesme değildir. Arka plandaki televizyon da değildir. VAPI'nin stopSpeakingPlan ayarları bu dengeyi kuruyor. Varsayılan olarak 0,2 saniyelik ses ajanı durdurmaya yetiyor (voiceSeconds), kelime sayısı eşiği 0 (numWords) ve ajan kesildikten sonra 1 saniye bekleyip yeniden başlıyor (backoffSeconds). Klinik randevusu gibi kısa onayların çok olduğu senaryolar için doküman 2–3 kelimelik eşik öneriyor.
Uyarı
Ölçüm: kayıttan ve p95 ile
Platformların gösterdiği aşama metrikleri faydalıdır ama kullanıcının deneyimini ölçmez, en dürüst ölçüm kayıt üzerinden müşterinin son sesi ile ajanın ilk sesi arasındaki boşluktur. VAPI arama bittiğinde kaydı iki kanallı olarak da veriyor (stereoRecordingUrl), kanal sırasını kendi kaydınızda bir kez doğrulayın. Müşteri bir kanalda, asistan öbüründe olunca boşluğu ölçmek basit bir enerji eşiği işine dönüyor:
# İki kanallı arama kaydında müşterinin sustuğu an ile asistanın ilk sesi# arasındaki boşluğu ölçer. Kanal 0: müşteri, kanal 1: asistan.# Kullanım: python3 bosluk_olc.py kayit.wav [esik_dbfs]import mathimport structimport sysimport wave CERCEVE_MS = 10EN_KISA_KONUSMA_MS = 120 # bundan kısa ses patlaması konuşma sayılmazBIRLESTIR_MS = 300 # bundan kısa sessizlik aynı konuşmanın parçası def kanallar(yol): with wave.open(yol, "rb") as w: assert w.getsampwidth() == 2 and w.getnchannels() == 2, "16 bit stereo bekleniyor" hiz = w.getframerate() ham = w.readframes(w.getnframes()) ornekler = struct.unpack(f"<{len(ham) // 2}h", ham) return hiz, ornekler[0::2], ornekler[1::2] def bolumler(sinyal, hiz, esik_dbfs): n = hiz * CERCEVE_MS // 1000 aktif = [] for i in range(0, len(sinyal) - n + 1, n): parca = sinyal[i:i + n] rms = math.sqrt(sum(x * x for x in parca) / n) or 1e-9 aktif.append(20 * math.log10(rms / 32768) > esik_dbfs) ham, bas = [], None for k, a in enumerate(aktif + [False]): if a and bas is None: bas = k elif not a and bas is not None: ham.append([bas * CERCEVE_MS, k * CERCEVE_MS]) bas = None birlesik = [] for b in ham: if birlesik and b[0] - birlesik[-1][1] < BIRLESTIR_MS: birlesik[-1][1] = b[1] else: birlesik.append(b) return [b for b in birlesik if b[1] - b[0] >= EN_KISA_KONUSMA_MS] def yuzdelik(degerler, p): s = sorted(degerler) return s[max(0, math.ceil(p / 100 * len(s)) - 1)] # en yakın sıra yöntemi def main(): yol = sys.argv[1] esik = float(sys.argv[2]) if len(sys.argv) > 2 else -45.0 hiz, musteri, asistan = kanallar(yol) m, a = bolumler(musteri, hiz, esik), bolumler(asistan, hiz, esik) bosluklar = [] for bas, son in m: sonraki = next((x for x in a if x[0] >= son), None) ustune = next((x for x in a if x[0] < son < x[1]), None) if ustune: print(f"{son / 1000:7.2f} sn müşteri asistanın sözünü kesti") continue if sonraki: bosluk = sonraki[0] - son bosluklar.append(bosluk) print(f"{son / 1000:7.2f} sn boşluk {bosluk:5d} ms") print(f"tur: {len(bosluklar)} p50: {yuzdelik(bosluklar, 50)} ms " f"p95: {yuzdelik(bosluklar, 95)} ms en kötü: {max(bosluklar)} ms") if __name__ == "__main__": main()Betiği denemek için bilinen boşluklarla yapay bir iki kanallı kayıt ürettim. Gerçek bir arama değil, beşinci turda tool call'u taklit eden uzun bir boşluk var. Ölçüm, verilen boşlukları birebir geri buluyor:
$ python3 bosluk_olc.py test.wav2.30 sn boşluk 640 ms 7.14 sn boşluk 710 ms 12.65 sn boşluk 820 ms 17.87 sn boşluk 690 ms 23.46 sn boşluk 2350 ms 29.91 sn boşluk 760 ms 35.57 sn boşluk 650 ms 39.62 sn boşluk 1480 ms 45.20 sn boşluk 700 ms 51.50 sn boşluk 730 mstur: 10 p50: 710 ms p95: 2350 ms en kötü: 2350 msBurada iki ders var. Medyan 710 ms ve on turun sekizi buna yakın, ama müşterinin hatırlayacağı tur 2.350 ms'lik olan. Ortalamaya ya da medyana bakan bir panel bu turu gizler. İkinci ders kaydın nerede alındığıyla ilgili. Platformun kaydı sunucu tarafında alınır. Müşterinin sesinin size gelişi, ajanın sesinin ona dönüşü ve telefonun jitter tamponu bu kayıtta görünmez. Kullanıcının gerçekten yaşadığı süre bu sayının üstüne iki ağ yolu ve bir tampon ekler. Bunu görmek için arada bir gerçek bir telefondan arayıp görüşmeyi cihaz tarafında kaydedin ve aynı betiği o kayda da uygulayın.
Kaydın söylemediği şey, zamanın nereye gittiği. Bunun için her turda aşama zaman damgalarını loglayın ve damgaları tek bir saatten alın, çünkü farklı sunucuların saatleri birbirinden kayabilir. Logdaki epoch değerlerini okurken Unix zaman damgası dönüştürücüsü işinizi görür. Aşağıdaki betik bu logdan bütçe tablosu çıkarıyor:
# Her tur için aşama zaman damgalarından gecikme bütçesi çıkarır.# Girdi: JSON Lines, her satır bir tur. Alanlar çağrı başından itibaren ms.# Kullanım: python3 butce.py turlar.jsonlimport jsonimport mathimport sys ASAMALAR = ["konusma_sonu", "stt_son", "tur_karari", "llm_ilk_token", "tts_ilk_ses", "hatta_ilk_ses"] def yuzdelik(degerler, p): s = sorted(degerler) return s[max(0, math.ceil(p / 100 * len(s)) - 1)] turlar = [json.loads(satir) for satir in open(sys.argv[1], encoding="utf-8")]sureler = {f"{a} -> {b}": [t[b] - t[a] for t in turlar] for a, b in zip(ASAMALAR, ASAMALAR[1:])}toplam = [t[ASAMALAR[-1]] - t[ASAMALAR[0]] for t in turlar] print(f"{'aşama':<30}{'p50':>7}{'p95':>7}")for ad, d in sureler.items(): print(f"{ad:<30}{yuzdelik(d, 50):>7.0f}{yuzdelik(d, 95):>7.0f}")print(f"{'uçtan uca (sunucu tarafı)':<30}{yuzdelik(toplam, 50):>7.0f}{yuzdelik(toplam, 95):>7.0f}")print(f"aşama p95'lerinin toplamı: {sum(yuzdelik(d, 95) for d in sureler.values()):.0f} ms")en_kotu = sorted(turlar, key=lambda t: t[ASAMALAR[-1]] - t[ASAMALAR[0]])[-1]pay = max(sureler, key=lambda ad: en_kotu[ad.split(" -> ")[1]] - en_kotu[ad.split(" -> ")[0]])print(f"en yavaş tur: {en_kotu['tur']}, en büyük pay: {pay}")Betiği 400 turluk yapay bir logla çalıştırdım. Dağılımları ben seçtim, hiçbir sağlayıcının ölçümü değiller. Amaç yalnızca p95'in nasıl davrandığını göstermek:
$ python3 butce.py turlar.jsonlaşama p50 p95konusma_sonu -> stt_son 153 301stt_son -> tur_karari 404 554tur_karari -> llm_ilk_token 462 1046llm_ilk_token -> tts_ilk_ses 206 393tts_ilk_ses -> hatta_ilk_ses 30 50uçtan uca (sunucu tarafı) 1296 1858aşama p95'lerinin toplamı: 2344 msen yavaş tur: 358, en büyük pay: tur_karari -> llm_ilk_tokenSon iki satıra dikkat edin. Aşamaların p95'lerini toplarsanız 2.344 ms bulursunuz, oysa uçtan uca p95 1.858 ms. Her aşamanın kötü günü aynı turda gelmiyor. Bütçeyi aşama p95'lerinin toplamıyla kurmak sizi gereğinden temkinli yapar. Uçtan uca p95'i hedef alıp aşamaları ona göre paylaştırmak daha gerçekçi. En yavaş turun en büyük payı hangi aşamada, o da son satırda yazıyor. İyileştirmeye oradan başlayın.
Sonuç
Bir hedef koyun ve onu kullanıcının kulağında ölçün: "sustuktan sonra ilk sese p95". Sonra bütçeyi kalemlerine dağıtın ve işe model değiştirerek değil, bekleme süresinden başlayın. Varsayılan 0,4 saniyelik bekleme her turda, her müşteriye, hiçbir modelin hızlandıramayacağı biçimde ödenir. Onu Türkçenin ritmine göre ayarlamak, ilk sesi önbellekten çalmak ve tool call turunu konuşarak doldurmak, daha hızlı bir LLM'e geçmekten önce gelir.
Sıkça Sorulan Sorular
- Gerçek zamanlı speech-to-speech modeller bu bütçeyi ortadan kaldırır mı?
- STT, LLM ve TTS'i tek modelde birleştirdikleri için o üç kalem arasındaki bekleme ve aktarma kalkar. Ağ yolu, telefon hattı, endpointing kararı ve tool call ise olduğu yerde kalır. Karşılığında her aşama için ayrı sağlayıcı seçme imkânını ve aşamaları ayrı ayrı ölçebilmeyi kaybedersiniz.
- p95'e güvenmek için kaç tur ölçmem gerekir?
- En yakın sıra yöntemiyle on turda p95 en kötü turun kendisidir. Yukarıdaki örnekte p95 ile en kötü değerin aynı çıkması bundan. Yirmi turda p95 ikinci en kötü değerdir. Tek bir uç değer sonucu belirlemesin istiyorsanız en az birkaç yüz tur toplayın ve tool call içeren turları ayrı bir grup olarak raporlayın, çünkü iki grubun dağılımı farklıdır.
- Önceden kaydedilmiş dolgu sesi ile TTS'e ürettirilen dolgu arasında ne fark var?
- Kayıtlı dolgu anında çalar, TTS kalemi sıfırdır. Bedeli ses uyumu: kaydın tını ve hızı asistanın sentez sesiyle aynı olmalı, yoksa müşteri iki farklı kişi duyar. Ses sağlayıcısını ya da sesi değiştirdiğinizde bütün dolgu kayıtlarını yeniden üretmeniz gerekir. Sağlayıcıların takılıp çıkarılabildiği bir yapıda bu kayıtları ses kimliğine bağlı bir önbellekte tutmak işi kolaylaştırır.
- Tarayıcıdan yapılan sesli görüşmenin bütçesi telefonla aynı mı?
- Hayır. WebRTC görüşmesinde taşıyıcı, SIP trunk ve çoğu transcoding adımı aradan çıkar ve tarayıcının kendi jitter tamponu ile eko engellemesi devreye girer. Buna karşılık kullanıcının Wi-Fi bağlantısı değişkenliği artırabilir. İki kanalı ayrı ölçün. Web widget'ı ile telefon numarası aynı asistanı kullanıyor olsa bile p95'lerin aynı çıkmasını beklemeyin.
Kaynakça
- International Telecommunication Union. (1988). Pulse code modulation (PCM) of voice frequencies (ITU-T Recommendation G.711). https://www.itu.int/rec/T-REC-G.711-198811-I/en
- International Telecommunication Union. (2003). One-way transmission time (ITU-T Recommendation G.114). https://www.itu.int/rec/T-REC-G.114-200305-I/en
- Schulzrinne, H., ve Casner, S. (2003). RTP profile for audio and video conferences with minimal control (RFC 3551). Internet Engineering Task Force. https://doi.org/10.17487/RFC3551
- Skantze, G. (2021). Turn-taking in conversational systems and human-robot interaction: A review. Computer Speech & Language, 67, 101178. https://doi.org/10.1016/j.csl.2020.101178
- Stivers, T., Enfield, N. J., Brown, P., Englert, C., Hayashi, M., Heinemann, T., Hoymann, G., Rossano, F., de Ruiter, J. P., Yoon, K.-E., ve Levinson, S. C. (2009). Universals and cultural variation in turn-taking in conversation. Proceedings of the National Academy of Sciences, 106(26), 10587–10592. https://doi.org/10.1073/pnas.0903616106
- Vapi. (t.y.). Speech configuration. Vapi Docs. https://docs.vapi.ai/customization/speech-configuration
Mustafa Kürşad Başer
Kıdemli Yazılım Mühendisi
Karmaşık sorunlara zarif çözümler üretmekten keyif alan, tutkulu bir yazılım mühendisi. Kodlamanın ötesinde, teknoloji, sanat ve insan bilincinin kesişim noktalarını keşfetmekle derinden ilgileniyor.